

Мы уменьшили рутину SEO-специалиста на 95% – вот архитектура, которая это сделала
В SEO есть задачки, которые забирают время, не создавая никакой ценности. Сбор семантики – одна из их. Спец вручную выгружает тыщи запросов, чистит их от мусора, группирует, инспектирует – и растрачивает на это деньки. В итоге заместо анализа и стратегии он занимается сортировкой таблиц. Это недешево и нерационально.
Мы выстроили автоматический процесс, который закрывает этот цикл за пару минут. Поведаем, как это устроено – и что это дает бизнесу.
Почему семантика – не попросту «перечень слов»
Если вы продвигаете веб-сайт в поиске, семантическое ядро – фундамент. Это те запросы, по которым вас должны отыскивать потенциальные клиенты. Верно собранное и сгруппированное ядро дозволяет осознать, какие странички необходимы на веб-сайте, какой контент на их писать и как расставить ценности по продвижению.
Неувязка в том, что у среднего интернет-магазина либо сервисной компании это тыщи запросов. И работать с ними вручную – означает часто выделять человека, который недельками занимается сортировкой и фильтрацией. При всем этом семантику необходимо обновлять: поисковые тренды изменяются, возникают новейшие продукты, соперники меняют стратегию.
Большая часть агентств решают это просто: выгружают данные из Key Collector либо Keys.so, отдают джуниору и ожидают. Это работает, но медлительно и с высочайшим процентом ошибок – человек утомляется, путается в дублях, пропускает нерелевантные запросы. Мы пошли иным методом.
Что такое n8n и для чего он нам нужен
n8n – это платформа для автоматизации действий с открытым кодом. Проще говоря, конструктор, в каком можно соединить различные сервисы в единую цепочку: забрал данные отсюда, обработал там, сохранил вот тут.
Ранее мы употребляли Make (он же Integromat). Он комфортен для обычных задач, но как объемы данных растут – упираешься в лимиты по операциям. На больших SEO-проектах с сотками тыщ запросов это становится настоящей неувязкой: необходимо повсевременно докупать ресурсы и смотреть за расходами.
n8n снял это ограничение. Тут нет лимитов на количество операций, можно строить сложные многошаговые сценарии, добавлять условия и свой код. Один сценарий соединяет воединыжды все: загрузку, чистку, анализ, кластеризацию и выгрузку.
Основное – мы не дали процесс на откуп ИИ. Искусственный ум без точного сценария делает ошибки: сочиняет нерелевантные запросы, некорректно группирует, игнорирует частотность. В нашей системе ИИ делает определенные аннотации на определенных шагах – под контролем человека.
Как устроен автоматический пайплайн: 5 шагов
Обычный подход к сбору семантики подразумевает линейную цепочку ручных операций: выгрузил, почистил, сгруппировал, проверил. Любой шаг просит роли спеца, и узенькое пространство тут не инструменты – а время и внимание человека меж ними.
Мы перестроили этот процесс в единый и сквозной, где спец участвует лишь на входе и на выходе. Все, что меж – характеристики, чистка, обогащение метриками, кластеризация, форматирование – производится автоматом по данному сценарию.
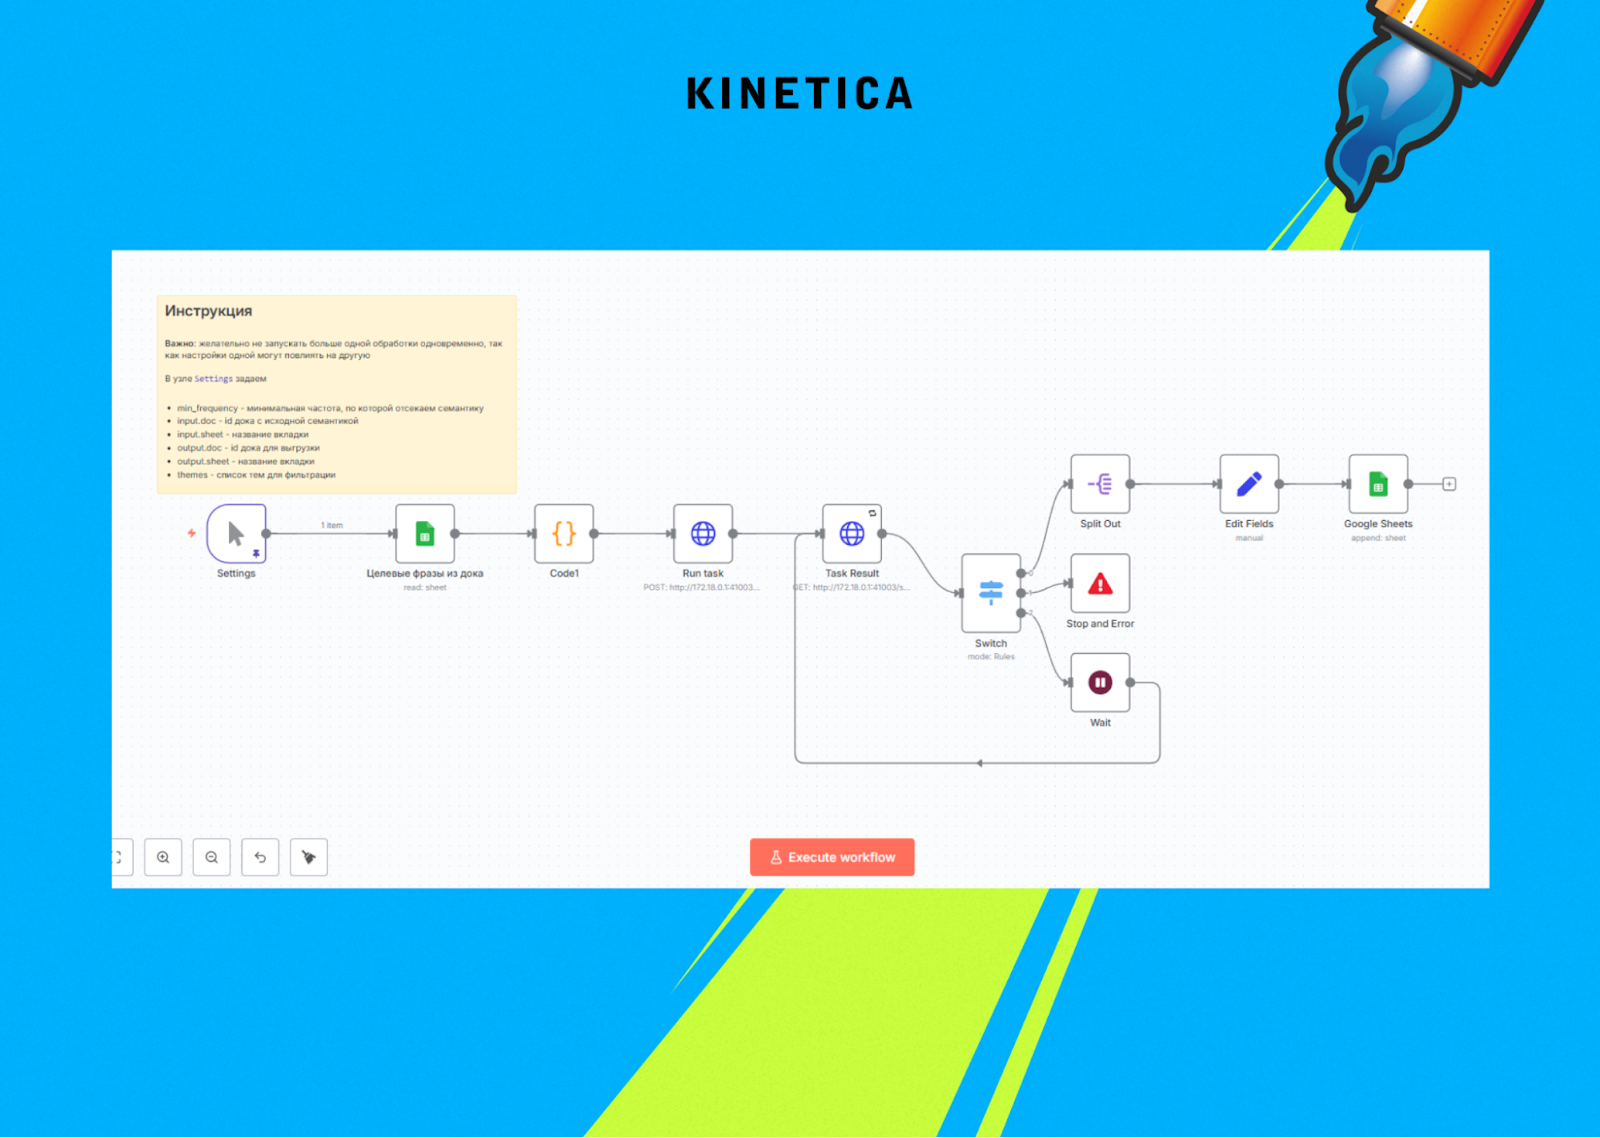
Схема автоматического пайплайна сбора семантики в n8n
Шаг 1. Загрузка и первичная чистка. Система подключается к Гугл-таблице с начальными данными. Спец заблаговременно задает характеристики: малая частотность запроса (к примеру, от 60 показов за месяц), главные темы, перечень стоп-слов. Сборочный поток конфискует данные и делает первичную очистку: убирает пустые строчки, технические дубли, тривиальный мусор.
Шаг 2. Умная обработка с ИИ. Тут в работу врубается свой анализатор KINETICA. Он употребляет языковую модель, которая умеет оценивать смысловую близость фраз – оставляет лишь те, что реально относятся к данным тематикам. Потом подтягиваются метрики по каждой фразе: частотность, коммерческость. Через GPT-4o-mini убираются смысловые дубли – с учетом географии и локализации. Низкочастотные запросы отсекаются. Оставшийся массив кластеризуется по направленным на определенную тематику группам.
Ключевое ограничение этого шага: ИИ работает строго по данному сценарию, без самодеятельности. Никаких «творческих» решений – лишь выполнение прописанных правил.
Шаг 3. Контроль свойства. Сборочный поток автоматом сортирует результаты: удачно обработанные фразы идут далее, ошибки записываются в отдельный лог, неопределенные результаты откладываются на ручную проверку. На огромных массивах данных добавлена пауза меж запросами – чтоб не перегружать наружные сервисы.
Шаг 4. Форматирование. Технические наименования переменных переводятся в понятные: «Фраза», «Кластер», «Частотность», «Коммерческость». Таблица собирается в читаемом виде.
Шаг 5. Выгрузка. Готовый итог автоматом записывается в Гугл Sheets. Спец получает документ, с которым можно работать сходу.
Итак, спец участвует два раза: задает характеристики на входе и работает с результатом на выходе. Все, что меж – работа машинки по данному и испытанному сценарию.
Конкретно это дозволяет размеренно поддерживать свойство на огромных размерах: метод не утомляется, не пропускает дубли из-за замыленного взора и не применяет различные аспекты к первой и крайней тыще фраз.
Пример: 400 000 запросов за пару минут
Мы протестировали сборочный поток на настоящем массиве: выгрузка из Keys.so на 400 000 запросов для большого интернет-магазина. Опосля автоматической обработки, которая заняла пару минут, из начальных 4 000 отобранных фраз (опосля внедрения малой частотности в 60 показов) вышло 13 800 незапятнанных, сгруппированных, готовых к работе запросов. Дубли убраны, кластеры сформированы, коммерческость проставлена.
Ранее таковой размер работы занимал у junior-специалиста 2–3 денька. Сейчас – 10 минут на загрузку и ожидание. При всем этом свойство кластеризации подросло: метод не утомляется, не допускает случайных ошибок к концу рабочего денька и не пропускает дубли из-за «замыленного взора».
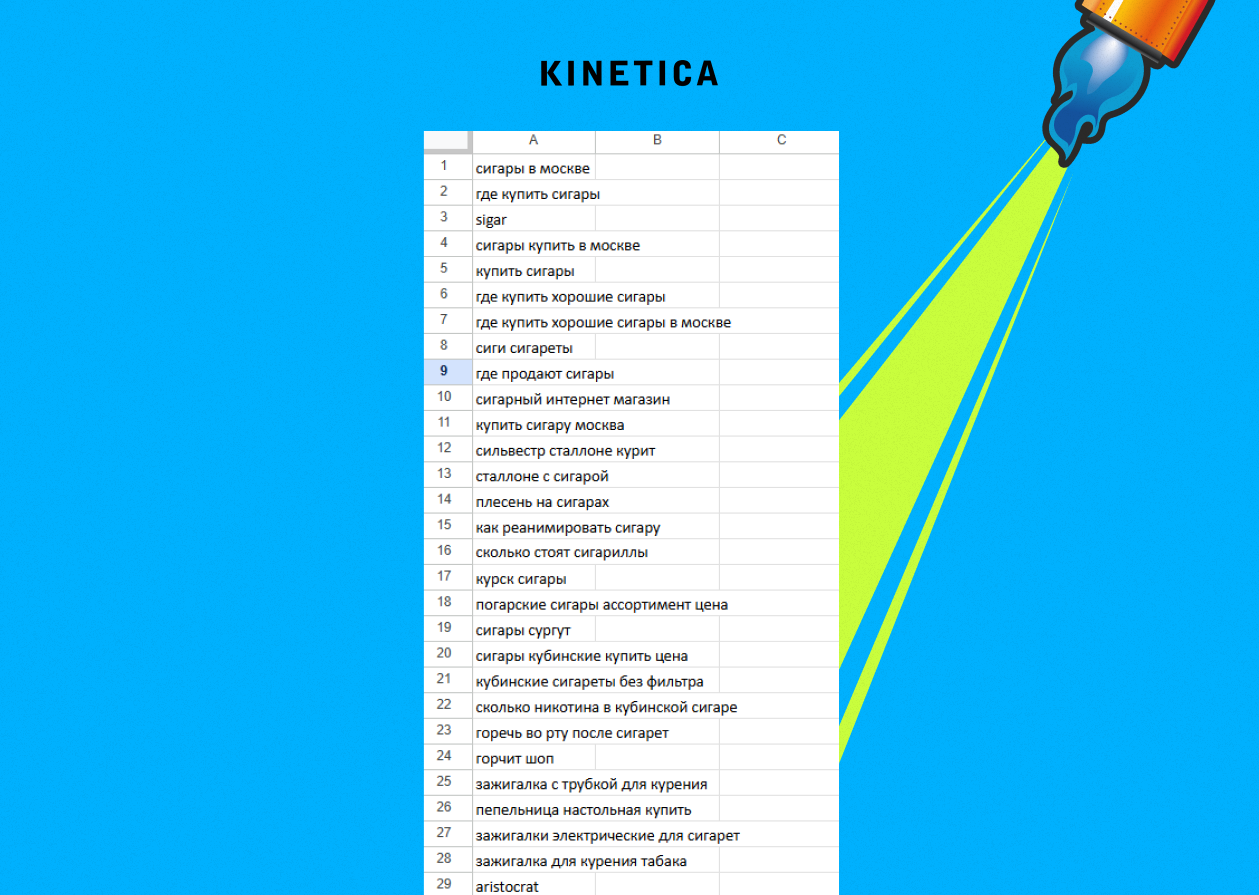
Таблица с необработанной семантикой – перемешаны коммерческие запросы, информационный мусор и нерелевантные фразы
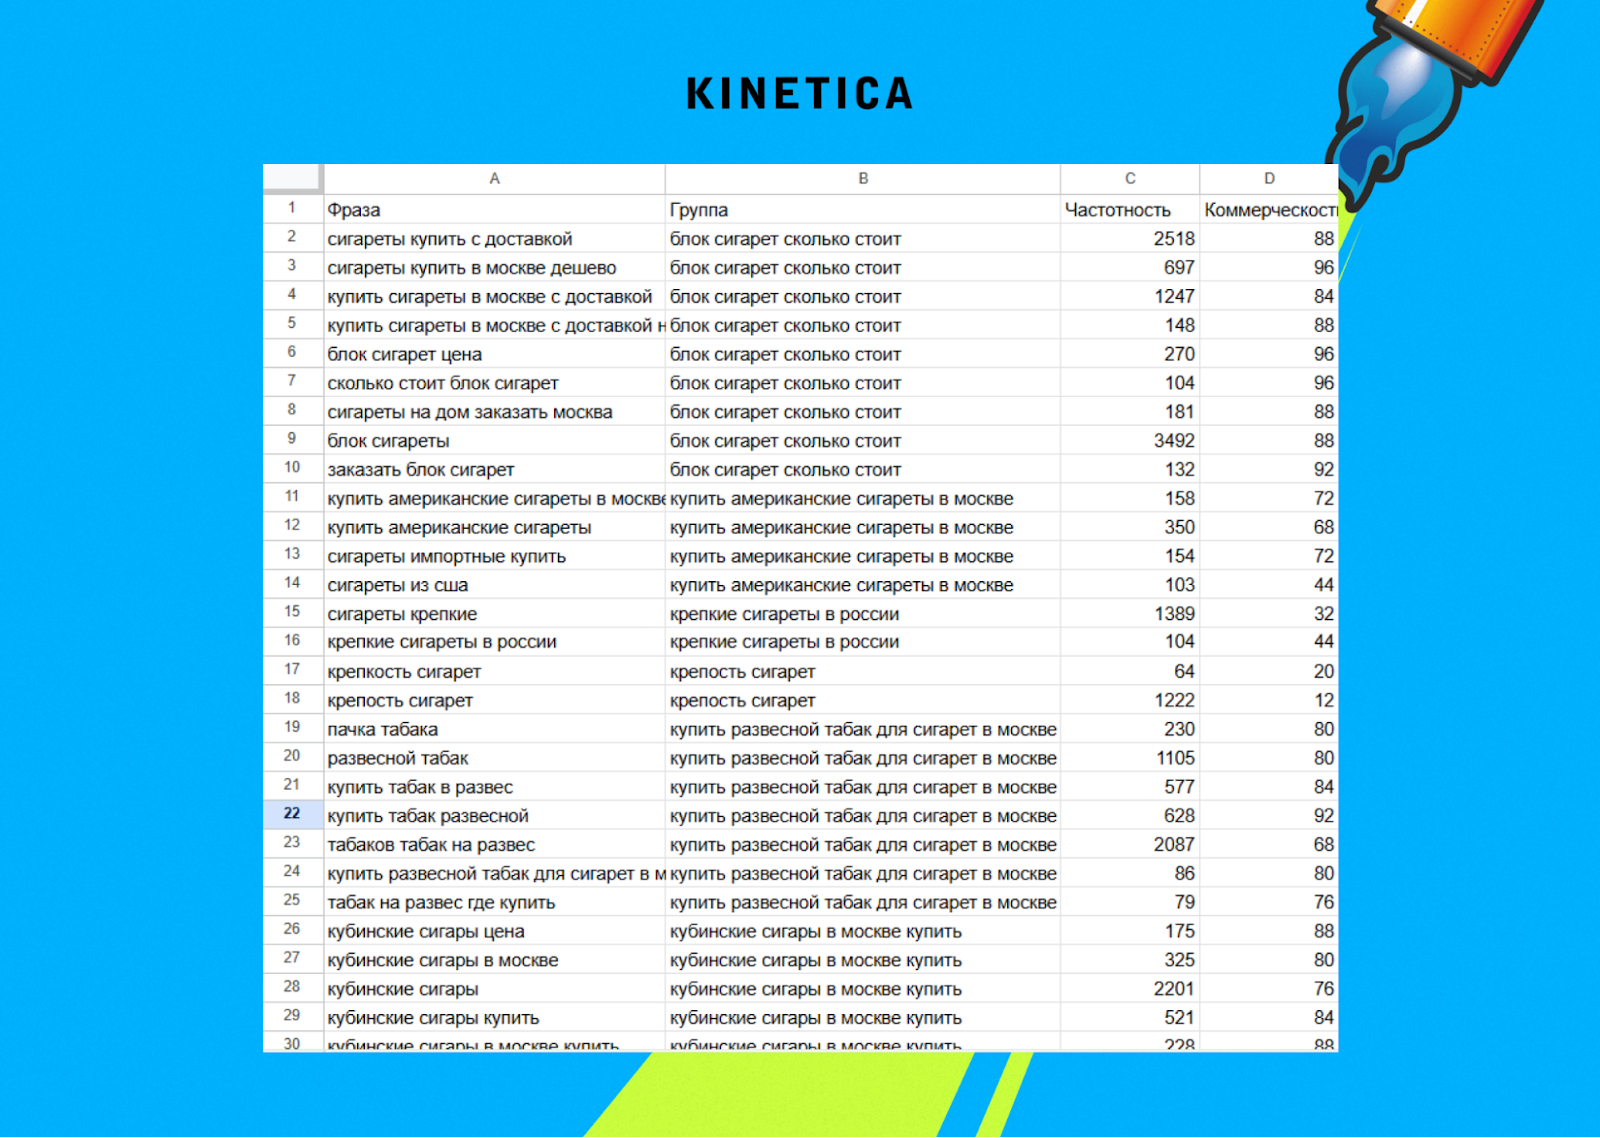
Таблица с запросами в поисковике, сгруппированными по кластерам с частотностью и коммерческостью
Автоматизация операционной части влияет не только лишь скорость – она впрямую влияет на то, чем спец занимается в течение рабочего денька. Вот три конфигурации, которые мы зафиксировали опосля внедрения пайплайна:
-
Быстроту реакции. Если необходимо обновить семантику под новейший раздел веб-сайта либо запустить продвижение новейшего продукта – ранее это занимало деньки. Сейчас несколько часов, из которых огромную часть занимает постановка задачки и финишная проверка, а не ручная работа.
-
Свойство без деградации. Ручная работа с большенными массивами данных безизбежно приводит к ошибкам. Спец утомляется, замыливается взор, пропускаются дубли либо нерелевантные запросы. Метод работает идиентично в пн днем и в пятницу вечерком.
-
Перераспределение фокуса. Это самое принципиальное. Когда спец не растрачивает деньки на рутину, он занимается тем, что вправду влияет на итог: анализом соперников, проверкой гипотез, работой с интентами и поведенческими факторами. Конкретно тут создается ценность.
До этого чем заавтоматизировать, разберитесь, на каком шаге ваши SEO-специалисты теряют больше всего времени. Нередко это не сбор семантики, а согласование структуры веб-сайта либо написание технических заданий на контент. Автоматизация имеет смысл лишь там, где задачка повторяемая и формализуемая.
Большая часть попыток заавтоматизировать SEO не работают
Кажется логичным: берешь ChatGPT, просишь собрать семантику – и готово. На практике это не работает по нескольким причинам.
Во-1-х, ИИ без ограничений генерирует шум. Он не понимает вашу нишу, не осознает, какая частотность вам релевантна, может придумать запросы, которых никто не отыскивает. Без точного сценария и контроля свойство ниже, чем при ручной работе.
Во-2-х, точечная автоматизация отдельных шагов не решает делему полностью. Можно заавтоматизировать выгрузку, но чистку созодать вручную. Либо заавтоматизировать кластеризацию, но всякий раз без помощи других готовить начальные данные. Экономия малая, а сложность процесса вырастает. Работает лишь сквозной пайплайн – когда автоматизирована вся цепочка от загрузки до выгрузки готового результата.
Если начинаете заавтоматизировать, не пытайтесь сходу охватить все. Возьмите один шаг, отладьте его на маленьких размерах, удостоверьтесь что свойство не ниже ручного – и лишь позже расширяйте.
Практические выводы для бизнеса
Автоматизация рутины – не вопросец технологий, а вопросец ценностей. Пока сотрудник чистит таблицы, он не анализирует соперников. Пока он переносит данные из 1-го сервиса в иной, он не задумывается над стратегией. Время естественно, и то, на что оно уходит, – управленческое решение.
В большинстве компаний от 60 до 80% рабочего времени профессионалов уходит на операционную рутину – данные, которые необходимо собрать, почистить, структурировать и передать далее. Это справедливо не только лишь для SEO, да и для денежного учета, логистики, клиентского сервиса, HR. Ветвь не имеет значения – имеет значение, есть ли в процессе повторяющиеся шаги с прогнозируемым результатом.
Если вы думаете о том, стоит заавтоматизировать рутинные процессы в собственной компании, вот несколько ориентиров:
-
Начинать с 1-го узенького места. Не пробовать заавтоматизировать сходу все. Избрать один циклический процесс с измеримым временем – к примеру, мы в команде начали с чистки данных, позже добавили кластеризацию, позже – выгрузку.
-
Фиксировать процесс до автоматизации. Заавтоматизировать хаос нереально. Поначалу необходимо обрисовать, что конкретно происходит на любом шаге, какие входные данные, какой ожидаемый итог, где появляются исключения. Без этого неважно какая автоматизация будет нестабильной.
-
Не убирать человека из контура на сто процентов. Это частая ошибка: заавтоматизировать процесс и не его надзирать. Ошибки в автоматических действиях масштабируются так же стремительно, как и результаты. Нужен постоянный контроль свойства на выходе.
-
Считать экономику. Если junior-специалист растрачивает 3 денька за месяц на рутину, а настройка автоматизации занимает 40 часов разраба – окупаемость наступает через несколько месяцев. Если таковых профессионалов пятеро, окупаемость резвее. Это рядовая инвестиция с расчетным сроком возврата.
-
Документировать все. Через полгода создатель сборочного потока может уйти либо запамятовать, для чего нужен тот либо другой блок. Без документации система становится черным ящиком, который жутко трогать.
Автоматизация – не метод работать меньше. Это метод перераспределить время туда, где от человека есть настоящая ценность: в анализ, решения, развитие. Рутина, которую можно обрисовать в виде правил, обязана производиться по правилам – без роли человека. Остальное – его работа.
Оригинал статьи на SEOnews