

Optimization 2023: текстовый анализ в 2024 году и способы роста релевантности страничек
На Optimization 2023 в рамках секции «Hard SEO» независящий SEO-эксперт Андрей Джилавдаров выступил с докладом «Текстовый анализ в 2024 году».
Андрей сказал:
- Как нейросети помогают сделать лучше свойство поиска.
- Как считывать интент, определенный нейросетью, и как выявить под него маркерные запросы для анализа.
- Показал практические способы роста релевантности страничек в конкурентных нишах, чтоб быть не «как все».
Все обзоры отыскиваете по тегу Optimization 2023.
Текстовое ранжирование
Задачка поиска – оценить и отдать ответ. Для этого у него есть инструменты (ML-машинное обучение (педагогический процесс, в результате которого учащиеся под руководством учителя овладевают знаниями, умениями и навыками), причины ранжирования, нейросети), оценки профессионалов и метрики свойства поиска, другими словами то, что поиск считает неплохим ответом.
История свойства поиска
- Если поглядеть на историю свойства поиска, то до 2016 года работали обыкновенные вещи (TF-IDF, ВМ-25, BCLM) – все, что соединено с вхождениями главных слов, количеством вхождений, порядком слов.
- С 2016 года были запущены 1-ые нейросети – Палех и Цариц (DSSM), также таргеты на обучение (педагогический процесс, в результате которого учащиеся под руководством учителя овладевают знаниями, умениями и навыками) – поведенческие причины.
- В 2019 году вышло 1-ое обучение (педагогический процесс, в результате которого учащиеся под руководством учителя овладевают знаниями, умениями и навыками) нейросетей на экспертных оценках. Тогда можно было поставить одно слово в Title и попасть в ТОП. Это были 1-ые обучения нейросетей на экспертной оценке.
- В 2020 году возникла новенькая архитектура для анализа текста – трансформер YATI.
- В 2021-2022 году вышло дообучение фактически во всех экспертных нишах, которые было принципиально оценить. Сначало там была медицина, но позже подтянули и другие.
Кратко про YATI
YATI – это просто очередной трансформер с улучшениями.
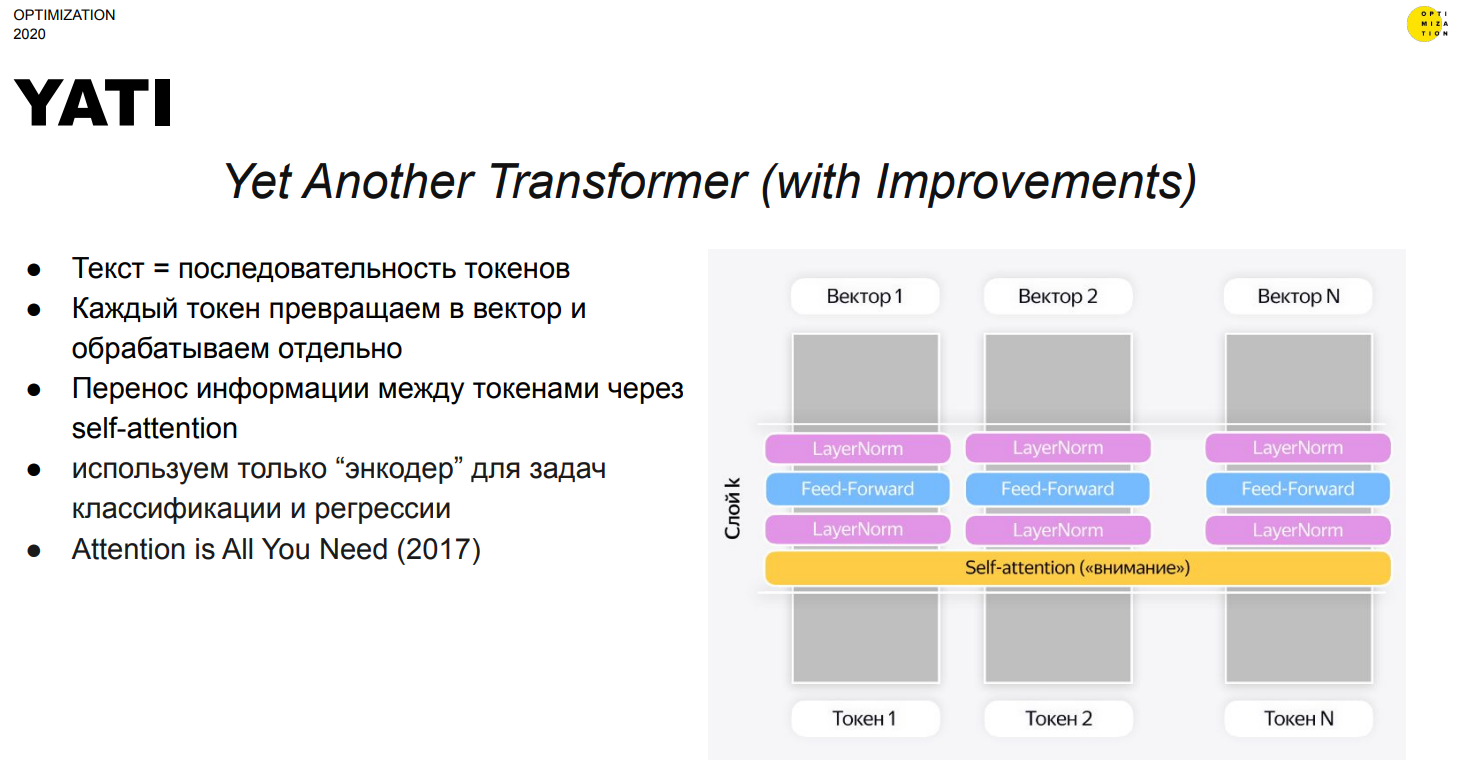
Схема устройства работы YATI
Эта таковая модель либо архитектура, которая разглядывает текст как последовательность токенов. Слово – это один токен. И потому что эта модель лицезреет текст стопроцентно, она превращает каждое слово в тексте в семантический вектор, который передает смысл слова в этом предложении.
В трансформерах есть механизм self-attention, потому он получает информацию и с окружающих слов, другими словами со всего текста совершенно. Таковым образом, получаем контекстозависимый смысл слова во всем большенном тексте.
При обучении YATI употребляли такую же модель обучения, как в BERT, Masked Language Model, когда половину слов в текстах закрывали и просили модель предвещать эти слова. Если она их корректно восстанавливала, тогда считали, что они ее научили. Но наряду с сиим они также просили ее угадать, был ли клик по документу, по данному запросу.
Далее нейросеть необходимо научить на наиболее сложные таргеты. Тут употребляются скопленные данные Yandex’а, такие как разметки по качеству хоста, разметки по релевантности страничек и многоаспектные оценки от профессионалов.
Как сделать лучше свойство поиска в сложных темах?
Сложные темы – медицина, техника, деньги, юриспруденция, софт, программирование и остальные. Сущность общая: обыденный человек, не эксперт, навряд ли сумеет осознать, что релевантно в выдаче по запросу, а что нет.
В чем могут быть препядствия?
- Трудности с метриками. Допустим, люди-асессоры не знают сложную тему и могут формально поставить релевантную оценку не тому веб-сайту.
- Трудности с моделями. К примеру, когда модели не лицезреют каких-либо слов, сленга либо некий контент части документа.
- Трудности с количеством релевантных хостов либо документов в индексе. К примеру, когда Гугл выкатил BERT, то оказалось, что Гугл указывает в выдаче большенный пласт мед веб-сайтов региональных клиник, в то время как в Yandex’е эти веб-сайты по мед запросам не брались даже в первичную обработку.
В 2021-2022 году Yandex улучшил нейросеть:
- добавили релевантные предложения;
- добавили в документную часть заглавия, начало текста документа (60 знаков) и description документа. Другими словами описание документа, который SEO-шники никогда не заполняли, на данный момент тоже идет в нейросеть, в представление документа.
Что такое релевантное предложение?
Когда человек отыскивает текст, поиск выбирает необходимое вхождение на пригодном веб-сайте и конфискует релевантный текст вокруг. Этот текст идет в представление расширения документа.
Очередной принципиальный пункт – на данный момент, когда юзер задает запрос, сходу определяется его тема. Потом из индекса уже выбирается группа веб-сайтов подходящей темы и посреди их идет ранжирование.
Свойства, которым должен владеть ответ
- Релевантность странички. Ответ должен соответствовать потребности юзера (содержать нужные вхождения).
- Наполненность странички. Ответ должен быть полным, учесть все вероятные интенты юзера. Это значит, что по почти всем тематикам, к примеру, мед, есть эталонные ответы.
- Регион юзера. Если содержание ответа зависит от региона, неплохой будет лишь та страничка, которая соответствует региону юзера.
- Актуальность инфы. Если содержание ответа изменяется с течением времени, неплохим будет тот веб-сайт, который содержит самую свежайшую сейчас информацию.
- Соответствие ОС. Мобильной либо десктопной версии для различных юзеров.
- Язык запроса. Ответ на языке юзера лучше, чем ответ на любом другом языке.
- Доверие к источнику (EAT). Ресурс, предоставляющий ответ, должен быть знатным. Нейросеть непревзойденно соображает, что за ресурс перед ней, и какого он свойства.
Интенты
На снимке экрана представлен перечень интентов, которые есть в медицине.
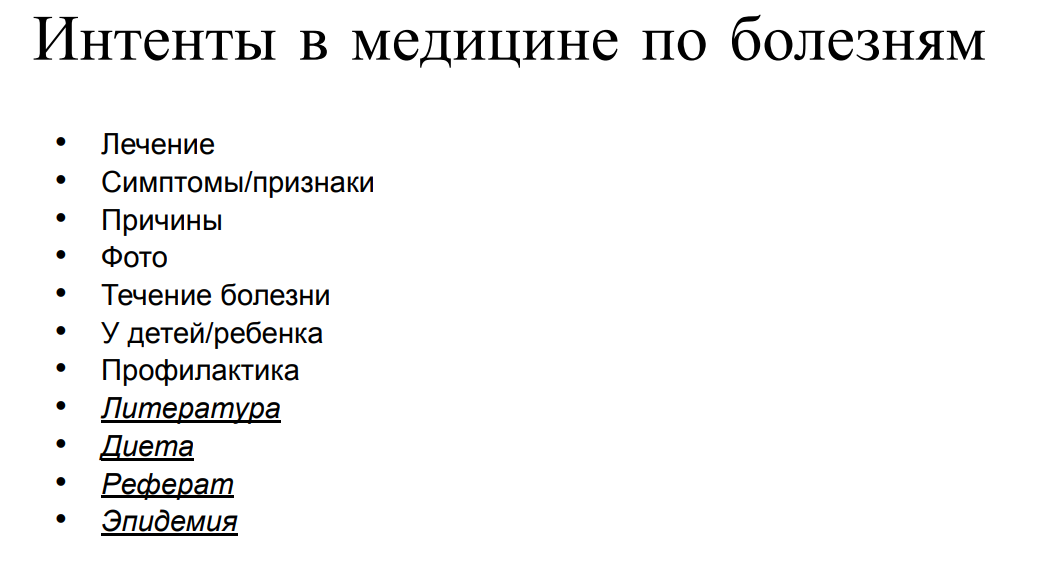
Интенты в запросах на мед тему
Но что созодать, когда интента в запросе нет?
Смотрим, что подается на данный момент в YATI для представления документа:
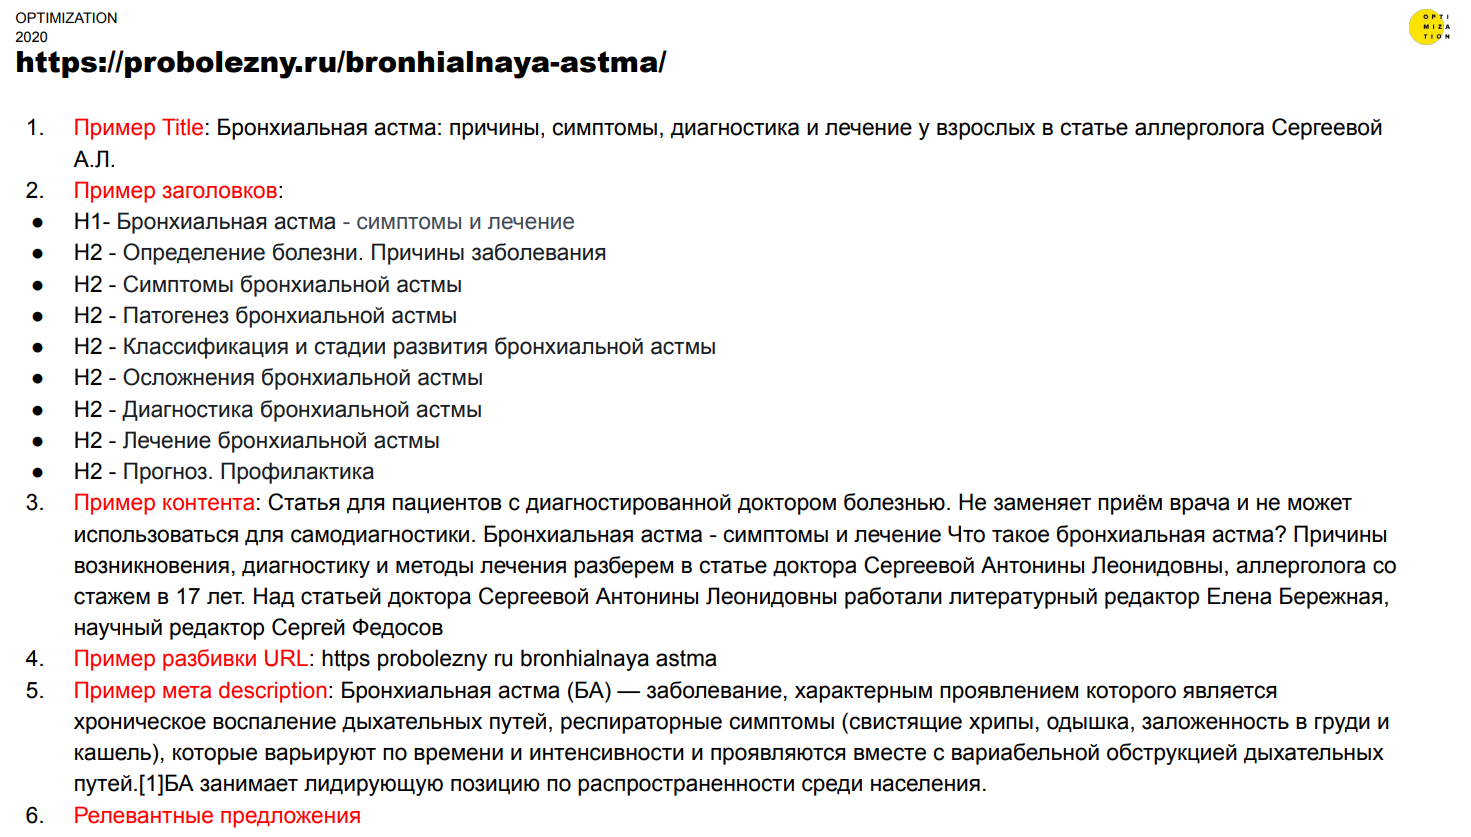
Пример представления документа в YATI
Здесь есть Title, подзаголовки, начало контента, разбивка URL, другими словами, виден хост, ЧПУ и description и релевантные предложения. Потому, когда вы анализируете запросы, вы сможете взять, к примеру, ТОП-30 выдачи и поглядеть у веб-сайтов все эти зоны и выстроить частотный словарь.
Нейросеть выводит те документы наверх, где прописаны точные интенты.
По словам Андрея, на данный момент один из самых продуктивных подходов – это просто взять вашу верхушку кластеров, поглядеть, какие в их есть интенты, и составить из их точное, подробное ТЗ, где будут прописаны все пункты по тексту.
Другими словами мы идем не от того, что у нас есть какие-то главные слова, мы идем от того, что у нас есть интенты, у всякого интента есть своя семантика, необходимо просто встраивать ее в статью.
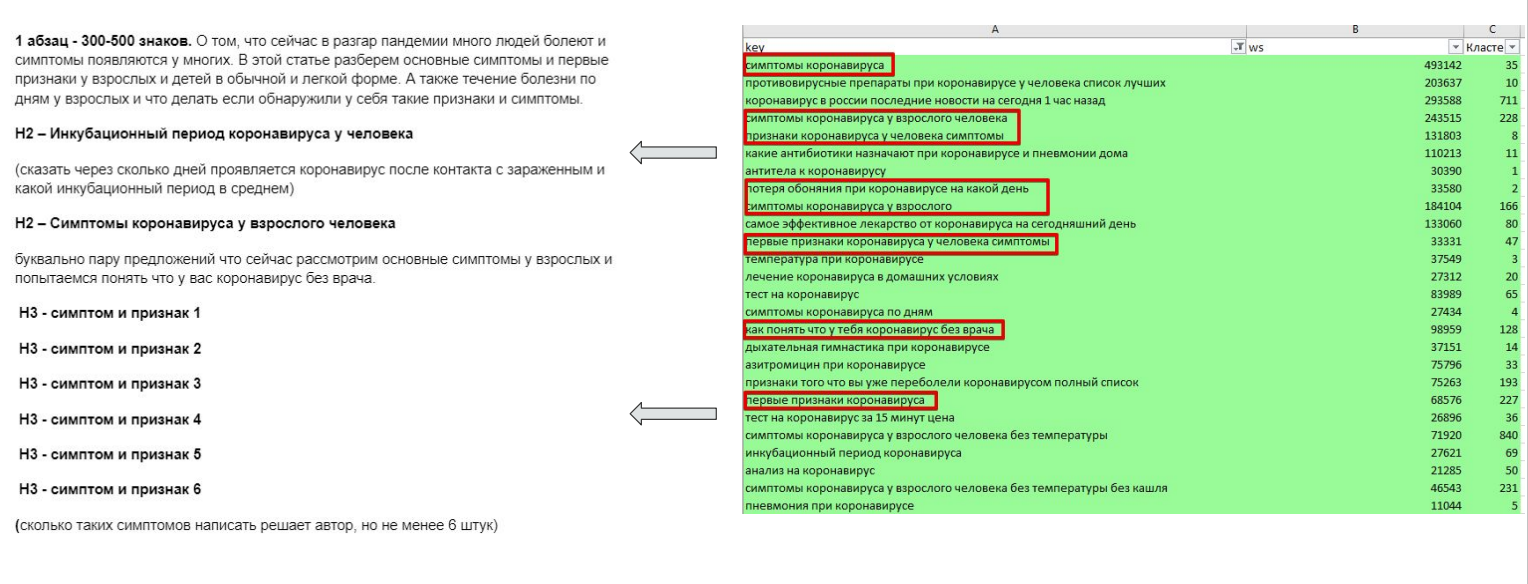
Структура статьи, где любая часть закрывает собственный интент
Но SEO-специалисты желают улучшить.
Как прирастить релевантность страничек?
Что можно создать еще:
1. Длинноватые вхождения главных слов (3 и наиболее слова) используем в Title и подзаголовках.
2. Вхождения ключей:
- из семантики делаем частотный словарь по униграммам, биграммам и триграммам;
- проверяем покрытие текста ключами из словаря.
3. В акварель генераторе just-magic.org. используем одно либо несколько частотных главных слов:
- проверяем покрытие текста биграммами из сервиса.
4. Делаем релевантные предложения = тексты для нулевых сниппетов.
Эти обыкновенные вещи помогают поднять релевантность текста.
Скоринг запросов по весу Seo-excel
Из ключей с частотностью можно выстроить скоринг либо по-другому «Частотность Климова».
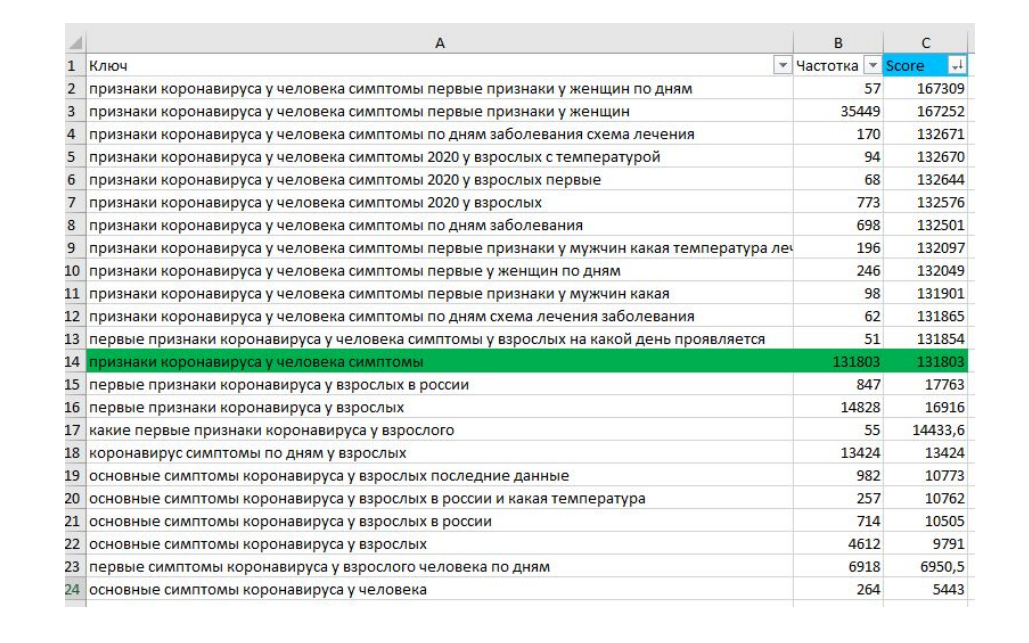
Скоринг запросов по весу Seo-excel
На снимке экрана в самом верху два запроса. Отличие лишь по окончанию. Смысл в том, что наверху находятся все запросы, которые покрывают правильным порядком слов наименее частотные запросы. Потому можно создать похожую разбивку и осознать, что возьмете в title, а что возьмете в подзаголовки.
Про семантику. Частотный словарь SemTools.guru
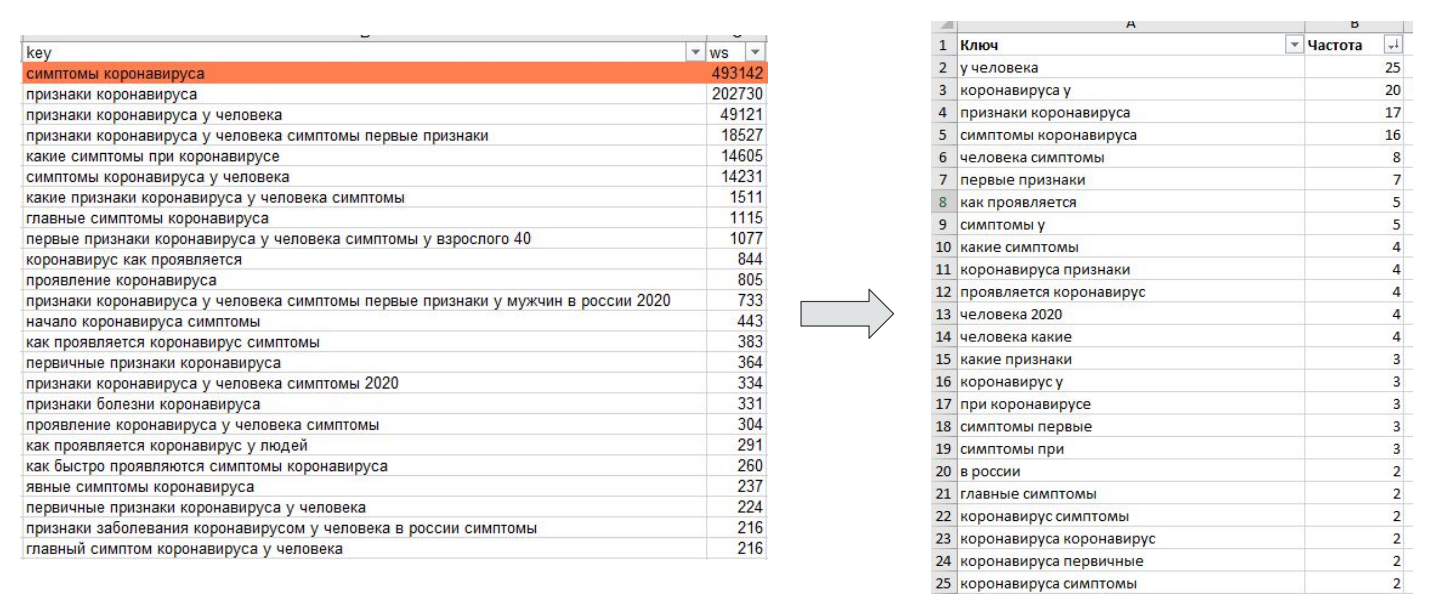
Частотный словарь SemTools.guru
Если у вас есть много запросов, то их не нужно все вставлять в текст. Довольно просто порезать их на униграммы, биграммы, другими словами разбить на маленькие фракции и проверить вхождения. Для разбивки можно применять хоть какой сервис, к примеру, SemTools.guru.
Направленные на определенную тематику слова JustMagic
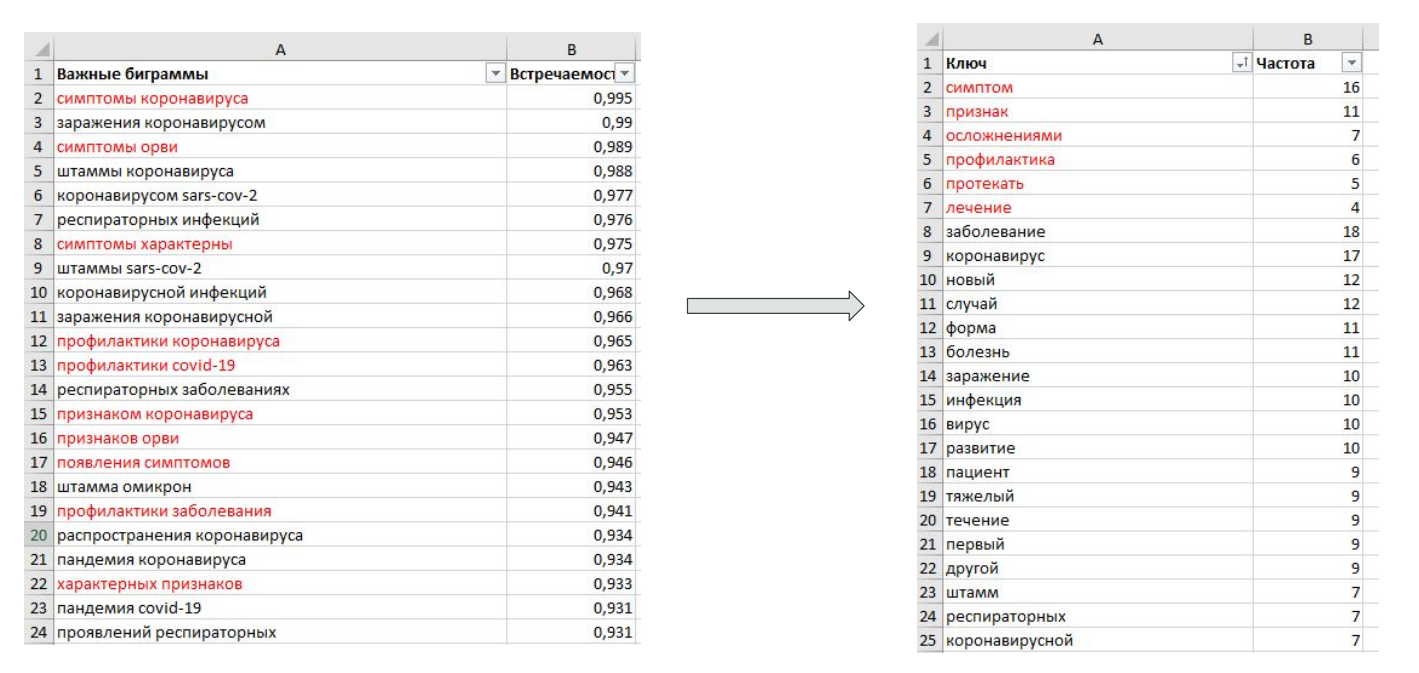
Направленные на определенную тематику слова в Just-magic.org
Принцип, схожий на предшествующий пункт. Андрей рекомендует брать биграммы запроса, поэтому что в Yandex’е весьма много оценок и таргетов конкретно по биграммам. И если мы построим частотный словарь, то увидим, что главные интенты с какими-то нашими словами находятся рядом. Это значит, что все корректно собралось.
Далее берем все наши униграммы, биграммы, направленные на определенную тематику слова и просто проверяем текст:
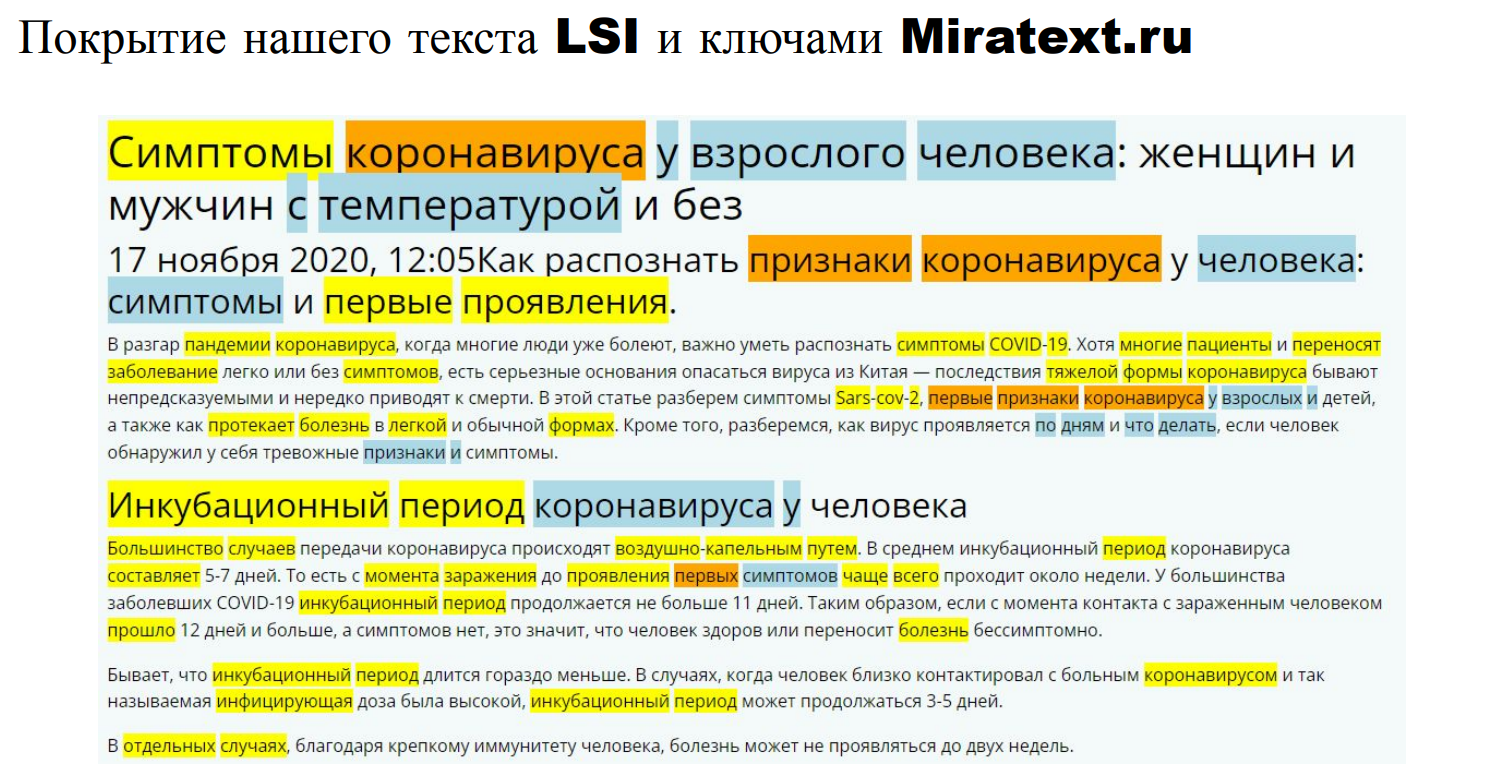
Если мы лицезреем приблизительно такую картину, это значит, что текст условно релевантный. Другими словами в нем все есть подзаголовки, вхождения запросов и это работает.
Релевантные предложения в Seolemma
В сервисе Seolemma есть функция релевантный пассаж. Другими словами в нем можно поглядеть вхождение ключа у себя и у соперников. Просто сопоставить.
Если у вас, допустим, все вхождения главных слов с какими-то словами, которые несут смысл «с водой», то сервис покажет, что IDF небольшой. А если с какими-то запросами, которые имеют смысл, то IDF большенный.
Сервис не от Yandex’а, но у него своя база, приблизительно в 30 миллионов URL, потому можно на него ориентироваться.
Как смотрятся релевантные предложения:
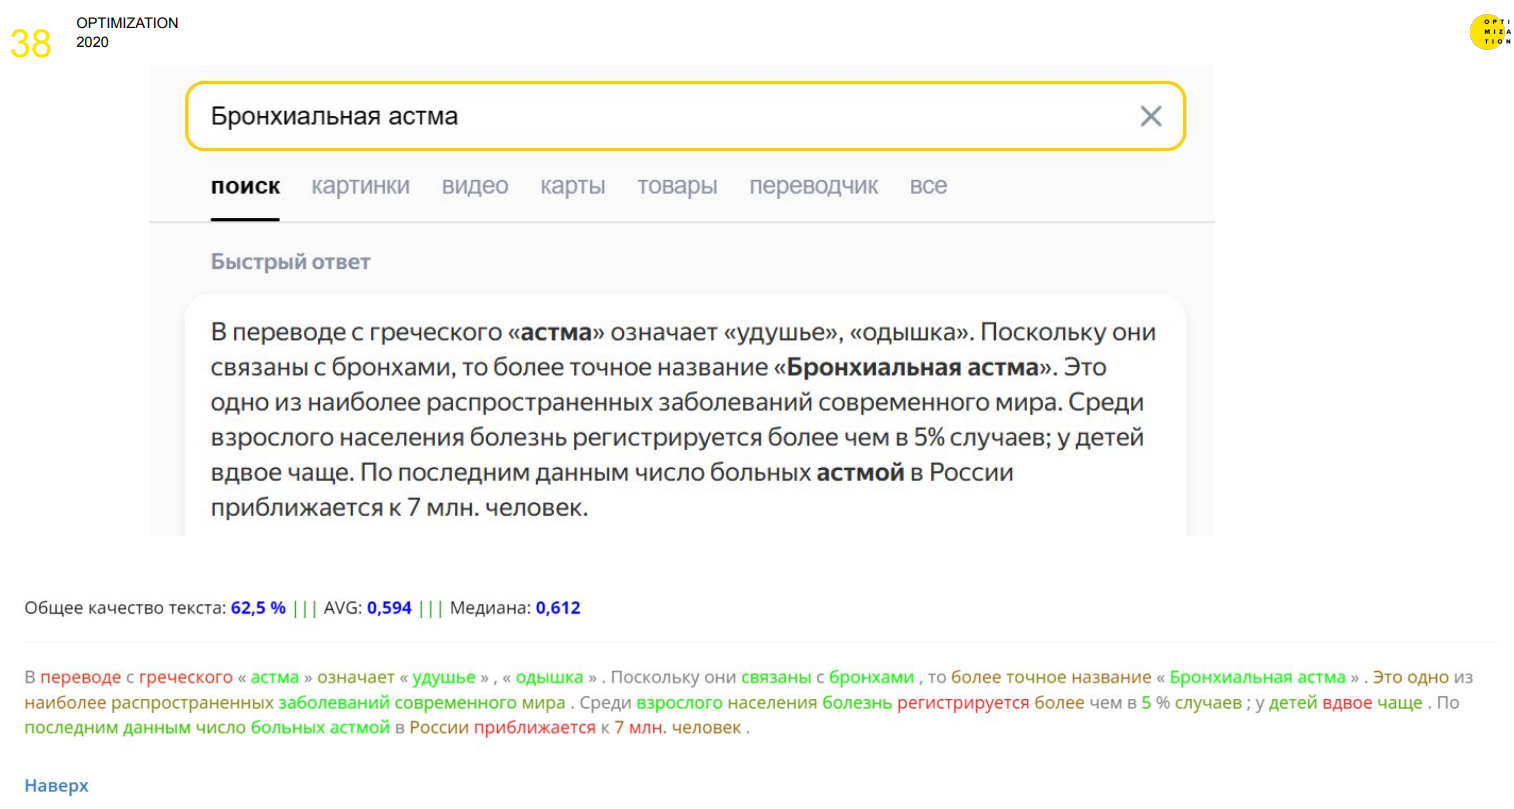
Можно созодать в тексте несколько схожих вкраплений. Мы берем хоть какой запрос, проверяем нулевой сниппет в Yandex’е либо в Гугл и стараемся в тексте у себя создать такое же пояснение.