

Как закрыть веб-сайт от индексации поисковыми роботами
Реклама. ООО «Клик.ру», ИНН:7743771327, ERID: 2VtzqvSWoDt
Чем резвее странички веб-сайта индексируются поисковыми роботами, тем резвее они попадают в поиск. Вот почему SEO-специалисты делают все вероятное для попадания веб-сайта в индекс. Но бывают и оборотные ситуации – когда необходимо стопроцентно закрыть веб-сайт от индексации либо запретить обход определенных страничек. Как и для что это делается – рассказываем в статье.
Для чего закрывать веб-сайт либо его странички от индексации
Отображение новейшего веб-сайта либо лишь что добавленных страничек на поиске происходит не одномоментно. Причина обычная – новейшие странички еще не проиндексированы поисковыми роботами. Лишь опосля того как поисковые боты проиндексировали добавленные странички и информация о их поступила в базу данных поисковой машины, страничка будет отображаться в поиске Yandex’а либо Гугл.
Юзеры лицезреют лишь те странички веб-сайта, которые содержат нужный для их контент. Эти странички открыты для поиска и проиндексированы. Но любой ресурс содержит рабочие документы и файлы, которые не несут полезности для гостей, а необходимы разрабам, админам, SEO-специалистам. Сюда относятся временные файлы, рабочая документация, внутренние ссылки, странички в разработке и иная служебная информация. Попадание таковых файлов в индекс лишь усложнило бы поиск по веб-сайту, сделало бы его структуру непонятной и понизило юзабилити ресурса.
Также от индекса могут запираться веб-сайты. Это животрепещуще в таковых ситуациях: когда разработка веб-сайта еще не окончена, происходит смена контента либо дизайна ресурса, изменяется структура веб-сайта и т. д.
Четыре предпосылки, почему веб-сайт лучше не регистрировать стопроцентно:
- Чтоб не утратить позиции в поисковой выдаче. Не вся информация на веб-сайте полезна для юзеров. Если служебные файлы, странички в разработке и остальной «мусор» попадет в поиск, никчемный контент в выдаче приведет к снижению позиций веб-сайта.
- Чтоб выполнить требования к уникальности контента. Поисковые машины требуют, чтоб на ресурсах был неповторимый контент. Потому если вы, к примеру, тестируете веб-сайт на другом домене, его необходимо закрыть от индексации. В неприятном случае бот примет такие странички как дубли.
- Чтоб убыстрить индексацию нужных материалов. Поисковые машины выделяют на любой ресурс краулинговый бюджет, другими словами определенное количество страничек для сканирования. Лучше, чтоб этот предел был израсходован на нужный для юзеров контент.
- Чтоб не навредить юзабилити. Если меняете структуру либо дизайн веб-сайта, лучше на это время скрыть ресурс от поисковых ботов. В неприятном случае, бот может зафиксировать понижение юзабилити площадки и снизить позиции веб-сайта в выдаче.
Управлять действием индексирования страничек на веб-сайте помогают два файла:
- sitemap.xml. Карта веб-сайта, которая помогает поисковым ботам ориентироваться посреди папок и документов веб-сайта. В этом файле можно прописать частоту обновления контента и ценность для каждой странички, тем управляя индексом. Карта веб-сайта нужна для огромных многостраничных ресурсов и веб-сайтов с глубочайшей вложенностью. Лендингам и сайтам-одностраничникам карты веб-сайта не необходимы;
- robots.txt. В этом файле задаются правила для ботов. Конкретно тут указываются характеристики сканирования веб-сайта либо устанавливается запрет для индексации определенных страничек.
Также для этих целей употребляется HTML-разметка и консоли веб-мастеров – Yandex Веб-мастер и Гугл Search Console.
Что можно закрыть от индексации через robots.txt
Через robots.txt можно закрыть от индексации весь веб-сайт, папку, файлы и документы, одну либо несколько страничек, ссылку либо даже отдельный абзац.
Поглядим, какие странички, файлы, документы и элементы веб-сайта можно (а в неких вариантах – нужно) закрывать от индекса.
Странички для служебного использования. Сюда относится все, что соединено с администрированием – служебные сборники и разделы веб-сайта. К примеру, форма авторизации в панели управления, применяемая админом, никак не поможет юзеру избрать продукт на веб-сайте и оформить заказ.
PDF документы. Такие документы могут предназначаться как для служебного использования, так и для юзеров. К примеру, содержать политику конфиденциальности, условия пользовательского соглашения, данные о ассортименте и ценах компании. Все служебные документы должны быть закрыты от индекса. А в случае с документами для юзеров необходимо рассматривать поисковую выдачу. В тех ситуациях, когда PDF документы показываются в рейтинге выше, чем странички веб-сайта со похожим запросам, их лучше закрыть от индекса, чтоб повысить доступность наиболее принципиальной и релевантной инфы.
Формы на веб-сайте и остальные элементы. Формы для ввода инфы, дизайна заказов и регистрации запираются от индекса, так как эта информация никчемна для поиска. Также запираются от индекса облака тегов, капча, корзина, всплывающие окна, раздел «Избранное».
Странички в разработке. Все странички, на которых изменяется дизайн либо контент, запираются от индексации. Также запираются от индекса дубликаты страничек, так как любая страничка обязана быть .
Копии веб-сайта. Бэкап создается для того, чтоб стремительно вернуть веб-сайт в этом случае, если «слетит» его рабочая версия. В настройках необходимо указать корректное зеркало при помощи 301 редиректа.
Интернет-страницы для печати. Время от времени для увеличения юзабилити веб-сайта на нем предусматриваются доп функции. К примеру, функция печати страничек. Такие странички создаются через дублирование. Если не закрыть от индексации интернет-страницы для печати, поисковые машины могут их просканировать и установить копию как приоритетную.
Личные данные юзеров. Данные юзеров должны быть исключены из поисковой выдачи. Потому от индекса запираются личные данные, платежная информация, контактная информация, история покупок и т. д.
Странички с плодами поиска по веб-сайту. Интернет-страницы с плодами поиска важны для юзеров, которые отыскивают на веб-сайте информацию, но она не принципиальна для поиска. Потому такие странички также запираются от поисковых ботов, как и странички с личными данными.
Как запретить индексирование веб-сайта либо страничек боту Yandex’а
Запретить поисковому боту Yandex’а регистрировать веб-сайт можно 3-мя методами: через файл robots.txt, HTML-разметку либо авторизацию на веб-сайте.
Как закрыть от индекса страничку, раздел либо веб-сайт через файл robots.txt
Главным поисковым ботом Yandex’а является YandexBot. Конкретно для него прописываются директивы, чтоб закрыть ресурс либо отдельные странички от индексации. Не считая Яндексбота у Yandex’а есть наиболее 10-ка остальных ботов, любой из которых делает свою задачку. К примеру, YandexMetrika – это бот Yandex.Метрики, YandexMarket – бот Маркета, YandexMedia – бот, который регистрирует мультимедийные данные.
Для закрытия странички от индексирования прописывается директива конкретно для YandexBot. Рассказываем, как это создать и какие команды прописывать.
Перейдите в robots.txt и пропишите там директиву Disallow. Директива Disallow воспрещает поисковому боту Yandex’а обход отдельных страничек либо целых разделов веб-сайта. С ее помощью можно закрыть от индекса дубли страничек, различные логи, сервисные странички, странички с секретными данными и т. д.
Какие команды можно прописать в файле robots.txt
Для запрета боту Yandex’а обходить весь веб-сайт пропишите:
- User-agent: Yandex
- Disallow: /
Для запрета обхода лишь тех страничек, адресок которых начинается с /catalogue, пропишите такую команду:
- User-agent: Yandex
- Disallow: / catalogue
Для запрета обхода страничек, URL которых содержит характеристики, пропишите:
- User-agent: Yandex
- Disallow: /page? – директива воспрещает обход страничек, URL которых содержит характеристики.
Как закрыть от индекса страничку, раздел, веб-сайт и отдельные элементы странички при помощи HTML-разметки
Как закрыть страничку от индекса
Если желаете закрыть от индекса определенные странички веб-сайта, пропишите в элементе head в HTML-коде метатег robots с директивой noindex, nofollow либо none.
Что обозначают эти директивы:
- noindex. Директива воспрещает поисковому боту регистрировать текст странички. Закрытая данной нам директивой страничка не будет участвовать в поисковых результатах.
- nofollow. Директива воспрещает боту перебегать по ссылкам на страничке.
- none. Эта директива не только лишь воспрещает боту регистрировать страничку, да и воспрещает ему перебегать по ссылкам на ней.
К примеру, если для вас нужно скрыть определенный контент на страничке и предупредить его возникновение в поиске, пропишите последующее:
< meta name="yandexbot" content="noindex, nofollow" >.
Если для вас необходимо закрыть целый раздел веб-сайта, пропишите директиву noindex в HTML-коде на каждой страничке раздела.
Как закрыть от индексирования часть текста
Если вы желаете скрыть от бота определенную часть текста на страничке, добавьте элемент noindex в HTML-код странички.
Это будет смотреться так:
< noindex >текст, который необходимо скрыть от индексирования< /noindex >
Очередной вариант – употреблять директиву noscript:
< noscript >текст, который необходимо скрыть от индексирования< /noscript >
Эта директива дозволяет не только лишь запретить боту регистрировать часть данной нам странички, да и скрыть этот отрывок от юзеров (при условии, что браузер юзера употребляет технологию JavaScript).
Как закрыть ссылку от индексирования
Если для вас необходимо не закрывать страничку от индексирования, но запретить боту перебегать по ссылкам, используйте директиву nofollow. Директива прописывается в HTML-разметке по тексту и проставляется там, где находится ссылка.
Как запретить индексирование при помощи авторизации
Если необходимо скрыть от индексации главную страничку веб-сайта, внедрение авторизации будет эффективнее, чем закрытие странички от индекса в файле robots.txt. Причина – даже если основная страничка закрыта для поиска в robots.txt, но на нее ведут ссылки с остальных веб-сайтов, таковая страничка все равно может попасть в индекс.
Время от времени неавторизованные юзеры могут попадать на закрытые странички. Чтоб предупредить эту ситуацию, для таковых страничек необходимо настроить код ответа сервера 404 Not Found.
Как проверить статус странички в Yandex Веб-мастере
Даже опосля того, как вы провели все нужные деяния по закрытию в robots.txt веб-сайта либо его отдельных страничек от индексирования, поисковые машины могут игнорировать прописанные директивы. В итоге веб-сайт может попасть в индекс стопроцентно.
Потому принципиально инспектировать статус веб-сайта и его страничек. Провести такую проверку можно в Yandex Веб-мастере.
Для проверки статуса отдельной странички перейдите в раздел «Индексирование» – «Проверить статус URL». Укажите адресок странички и нажмите на клавишу «Проверить».
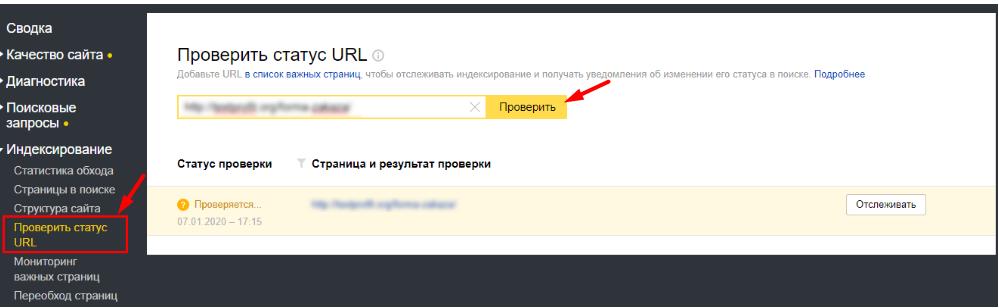
В сформированном отчете будут содержаться таковая информация:
- код статуса HTTP;
- адресок странички;
- дата и время крайнего сканирования странички поисковым роботом;
- статус странички во время крайнего обхода роботом;
- одержимое title.
Для проверки всех проиндексированных страничек сходу перейдите в раздел «Индексирование» – «Странички в поиске». Сформированный отчет будет состоять из таблицы со перечнем URL страничек, их статусами, заголовками и датами крайней индексации.
Для того чтоб в этом отчете отыскать странички, удаленные из поисковых результатов, необходимо в столбце «Статус и URL» отсортировать результаты по статусу «Удален: Ошибка HTTP». В этом случае в отчете покажется перечень адресов страничек, которые удалены из поисковых результатов, и указан код ошибки.
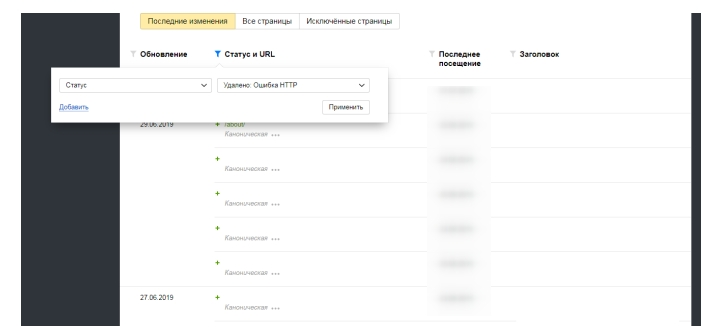
Как закрыть веб-сайт от бота Гугл
Заблокировать поисковым ботам Гугл доступ к веб-сайту можно также через robots.txt, HTML-разметку либо указать аннотацию для Googlebot в HTTP-заголовке.
Как заблокировать доступ бота к страничке через robots.txt
Главным поисковым роботом Гугл является Googlebot. Его задачка – регистрировать странички и инспектировать их на адаптивность под мобильные устройства. Но также у Гугл есть десяток остальных роботов, любой из которых делают свою задачку. К примеру, Googlebot-News сканирует страничку с новостями и добавляет их в Гугл Анонсы, Googlebot-Video регистрирует видеоконтент на страничках веб-сайта, а Googlebot-Image – изображения.
Управление индексированием веб-сайта либо отдельных его страничек для Googlebot в файле robots.txt происходит при помощи той же директивы Disallow, что и для поискового бота Yandex’а.
Другими словами, для того чтоб закрыть обход всего веб-сайта для бота Гугл, в файле укажите:
- User-agent: Googlebot
- Disallow: /
Если для вас нужно закрыть обход определенной странички, пропишите такую директиву:
- User-agent: Googlebot
- Disallow: / page
Для закрытия обхода раздела прописывается директива:
- User-agent: Googlebot
- Disallow: / catalogue
Для закрытия раздела с новостями от индекса поисковым роботом Googlebot-News пропишите директиву:
- User-agent: Googlebot-News
- Disallow: / news
Если необходимо закрыть веб-сайт стопроцентно от поисковых ботов Yandex’а и Гугл, не непременно прописывать для их различные директивы. Это можно создать одной командой.
- User-agent: *
- Disallow: /
В первой строке заместо имени агента ставится символ «*».
Как запретить индексирование содержимого странички через HTML-разметку
При помощи HTML-разметки можно закрыть от индексации роботом Гугл целую страничку либо определенную ее часть. Для этого пропишите метатег «googlebot» с директивой noindex либо none.
Для того чтоб ограничить боту Гугл доступ к страничке вашего веб-сайта, на HTML-странице вы сможете прописать такие команды:
1. Если желаете скрыть определенный контент на страничке и предупредить его возникновение на поиске и в Гугл News, пропишите команду:
< meta name="googlebot" content="noindex, nofollow" >
2. Если желаете запретить индексирование определенных изображений на страничке, пропишите команду:
< meta name="googlebot" content="noimageindex" >
3. Если на веб-сайте весьма стремительно устаревает актуальность контента, к примеру, у вас новостной портал, либо вы проводите акции и не желаете, чтоб в индекс попадали странички с неактуальной информацией, пропишите команду, когда страничка обязана быть удалена из индекса Гугл.
К примеру, вы расположили на веб-сайте новость о проведении Темной пятницы. Срок окончания акции – 29 ноября. Команда будет смотреться так:
< meta name="googlebot" content="unavailable_after: 29-Nov-2023 15:00:00 EST" >
Что касается индексирования ссылок, в Гугл есть два доп параметра, которые указывают поисковику на происхождение линков:
- rel=»ugc» – употребляется в этом случае, если у вас на ресурсе есть форум, где юзеры делятся отзывами и оставляют свои ссылки. В качестве таковых ссылок трудно быть уверенным, и этот атрибут помогает боту осознать, откуда взялась ссылка.
- rel=»sponsored» – употребляется в этом случае, если на веб-сайте расположена маркетинговая ссылка, которая показывает на размещение в рамках партнерской программки.
Как проверить статус странички в Гугл Search Console
В Гугл Search Console также предусмотрена возможность проверки статуса странички. Для этого в боковой панели изберите раздел «Инструмент проверки URL», введите подходящий адресок и кликните на «Изучить просканированную страничку».
Если страничка исключена из индексирования, в отчете будет сообщение о том, что URL нет в индексе Гугл.
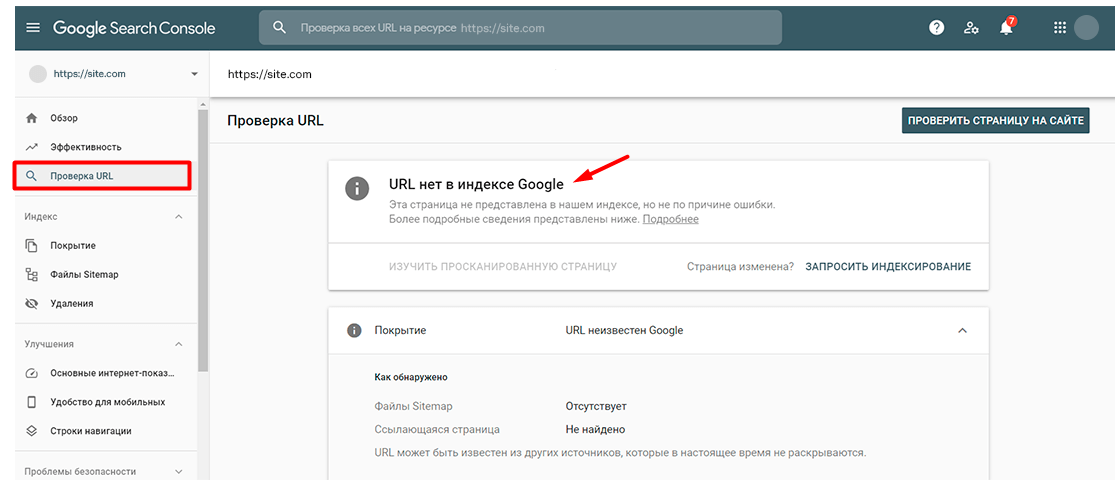
В Гугл Search Console также можно проверить все странички веб-сайта. Для этого перейдите в раздел «Статус индексирования» и сформируйте отчет с плодами сканирования. В отчете будут представлены результаты сканирования, сгруппированные по статусу (ошибка, предупреждение, без ошибок) и причине (код ответа HTTP).
Не считая Гугл Search Console и Yandex Веб-мастера есть и остальные инструменты и онлайн-сервисы, дозволяющие проверить статус страничек веб-сайта. К примеру, в PromoPult есть «Анализ индексации страничек», который стремительно проверит индексацию всего веб-сайта либо отдельных страничек в Yandex’е и Гугл. Необходимо лишь загрузить XML-карту, XLSX-файл со перечнем URL либо ввести нужные адреса страничек вручную. Подробная {инструкция} по работе с инвентарем – тут.
Почему веб-сайт не индексируется
Время от времени происходит так, что веб-сайт не индексируется поисковыми машинами, хотя никаких особых мер для этого не предпринималось.
Почему так может случиться:
- Веб-сайт новейший. Поисковикам требуется время на индексирование новейшего веб-сайта. Но этот процесс можно убыстрить. К примеру, запросить индексирование страничек можно в Yandex Веб-мастере либо Гугл Search Console.
- Опции приватности на веб-сайтах с готовой CMS. На таковых площадках нередко стоят опции приватности по дефлоту, из-за что веб-сайт не индексируется поисковыми машинами.
- Веб-сайт заблокирован в файле robots.txt. Просмотрите содержимое файла и удостоверьтесь, что в нем не прописаны директивы, которые закрывают веб-сайт от индекса.
- Препядствия с хостингом либо обслуживанием. Если во время обхода бота веб-сайт был недоступен, странички не будут внесены в базы данных поисковых машин.
- Ошибки при сканировании. При большенном количестве ошибок бот не может обойти веб-сайт. Проверить веб-сайт на наличие ошибок можно в панелях веб-мастеров.
- Доступ к веб-сайту закрыт в файле htaccess. Проверьте файл на содержание запрещающих индексирование установок.
- Отсутствует карта веб-сайта. Файл sitemap.xml нужен для многостраничных веб-сайтов и время от времени может стать предпосылкой «незаметности» ресурса для поисковых машин.