

Как работают текстовые причины ранжирования для информационных проектов. Исследование «Ашманов и партнеры»
Специалисты компании «Ашманов и партнеры» тщательно поведали, как работают текстовые характеристики в Yandex и Гугл при ранжировании веб-сайтов. Информация будет полезна спецам, которые ведут контентные проекты. Данные были получены в процессе исследования «Информационные запросы: причины ранжирования в Yandex и Гугл».
Для исследования специалисты взяли три подборки веб-сайтов из категорий: Косметика, Девайсы, Наука.
Главные выводы, как работают текстовые причины ранжирования для инфопроектов
- Для информационных запросов ранжирование – это конкурентность мощных веб-сайтов с релеватными текстами. Исследование показало, что ранжирование информационных ресурсов по текстовым характеристикам схоже с коммерческим ранжированием, в особенности в Yandex’е.
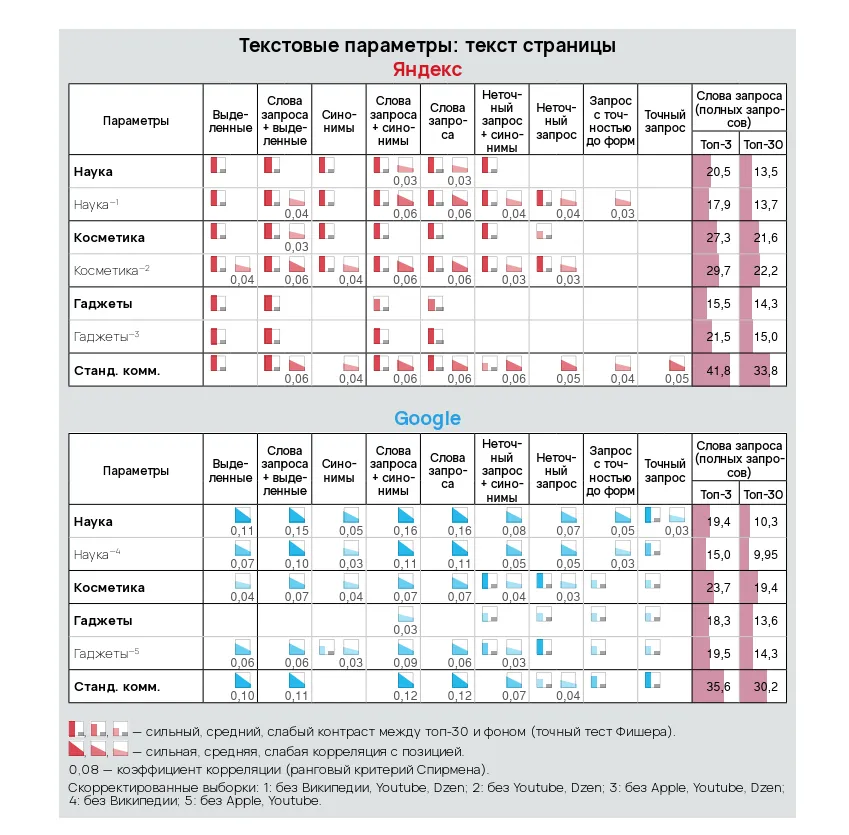
- Yandex больше направляет внимание на текстовые характеристики, к примеру, на вхождение слов запроса в тексты и заглавия. Для Гугл значение текстовых характеристик ниже, но зависимость позиций от их посильнее, чем в Yandex’е.
- По воззрению профессионалов, текстовые причины в Yandex’е участвуют в подготовительном отборе веб-сайтов – когда метод поиска анализирует релевантность странички запросу. Потом система учитывает при ранжировании остальные аспекты. В итоге текстовые причины посильнее отражаются на выходе в топ Yandex’а, чем на положении снутри него. А в Гугл они имеют большее значение конкретно для позиций.
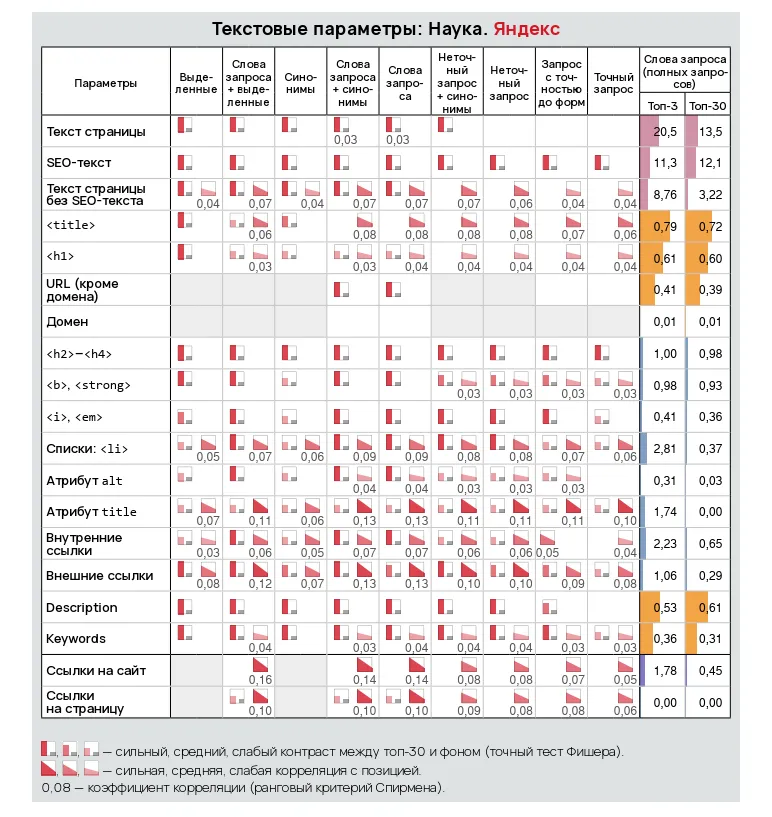
- Исследование показало, что основная зона для текстового ранжирования – текст странички полностью. Главные фразы лучше работают, когда включены в текст в разрозненном виде, и чем они далее от четкой формы запроса, тем лучше. Поисковые машины учитывают синонимы, слова по теме и остальные слова, связанные с запросом. И таковых разрозненных и близких по смыслу вхождений обязано быть много.
- Исследование показало, что лучше в выдаче представлены тексты, которые содержат на веб-сайте либо в корпоративном блоге много запросов в поисковике. Так, в топе Yandex’а почаще встречаются тексты, которые включают разрозненные части 13–21 запросов в поисковике, а в Гугл – тексты с рандомно включенными словами из 10–19 запросов.
- Наиболее длинноватые тексты больше нравятся поисковым системам. Размер текста коррелирует с позицией при ранжировании.
- Вхождений запросов в поисковике в title обязано быть много. Гугл ценит заглавия, которые на сто процентов совпадают с запросом. В Yandex’е значение заголовков title и Н1 быстрее выше, чем в Гугл, и в информационных подборках их значение посильнее, чем в коммерческом ранжировании.
- Заглавия H1 демонстрируют похожее с title значение для ранжирования.
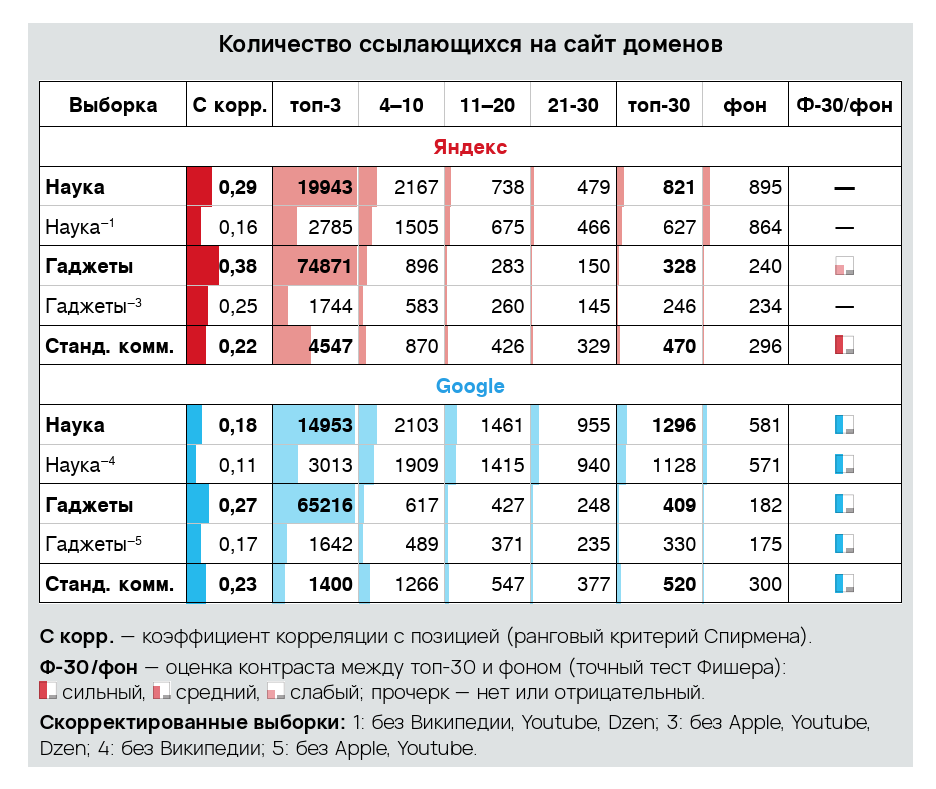
- Ссылочные причины как и раньше сильны в Yandex’е и Гугл, но работают по-разному. В Yandex’е ссылочные характеристики очень коррелируют с позицией. При всем этом их значения приметно падают при переходе от топ-3 к топ-30. В Гугл средние значения для топ-30 выше, чем в Yandex’е. При всем этом понижение значений от топ-1 к топ-30 происходит медлительнее.
- Внутренние ссылки со странички – одна из самых активных зон текстового ранжирования. Специалисты считают, что релевантные запросу внутренние ссылки полезны, потому что указывают на размер ресурса и выстроенную структуру.
- Число ссылок, релевантных запросу, на весь веб-сайт важнее, чем на определенную страничку. Также есть корреляция меж толикой анкорных ссылок на веб-сайт и позициями. Основное в анкорах – не включение четких вхождений, а направленная на определенную тематику релевантность запросу.
Напомним, ранее «Ашманов и партнеры» выпустили первую и вторую часть исследования. 1-ая вышла в мае 2024 года, 2-ая в августе 2024 года.