

Дублированный контент в SEO: предпосылки, воздействие и методы устранения
Дублированный контент – один из главных причин, который может плохо воздействовать на SEO-результаты вашего веб-сайта. Мы, команда из Топвизор-Журнальчика, перевели и адаптировали статью Стивена ван Вессума для Conductor.com, чтоб создать еt полезной для русских профессионалов.
Дублированный контент предполагает наличие весьма схожего либо схожего контента на различных интернет-страницах. Он не представляет никакой ценности для гостей веб-сайта и сбивает с толку поисковые машины. Предпосылки дублированного контента – технические проблемы и скопированный вручную контент.
Дублированный контент вредоносен для SEO веб-сайта. При всем этом есть действенные методы предотвращения заморочек, связанных с дублированием контента. Конкретно их мы разглядим в данной статье, также поделимся воззрениями профессионалов в SEO о дублированном контенте.
Что такое дублированный контент и чем он плох для SEO
В узеньком смысле дублированный контент – это весьма схожий либо схожий контент, размещенный на различных страничках вашего либо остальных веб-сайтов.
В широком смысле – это контент, который не несет никакой ценности для ваших гостей. Потому странички, на которых фактически отсутствует содержимое (в теге < body/ >), также числятся дубликатами.
К недочетам дублированного контента можно отнести последующее:
-
При наличии нескольких версий контента поисковым системам тяжело найти, какую из их нужно проиндексировать и потом показать в поисковых результатах. Это понижает производительность всех версий контента, которым приходится соперничать вместе.
-
У поисковых машин могут появиться трудности с закреплением метрик ссылок (авторитет, значимость и доверие) для контента. В особенности когда остальные веб-сайты ссылаются на наиболее чем одну версию этого контента.
|
Барри Адамс, эксперт по новостному SEO: Дубликаты вызывают суровые трудности с SEO и отправляют конфликтующие сигналы поисковым системам. У вашего контента должны быть неповторимые URL-адреса, и сам контент должен быть неповторимым. Любая страничка так будет иметь больше шансов на высочайший рейтинг и вербование трафика. |
Есть ли санкции за дублированный контент
Дублированный контент может разрушить оптимизации, но вы не получите штраф от Гугл до того времени, пока не копируете чей-то веб-сайт специально. Если же вы скопировали огромное количество чужого контента, другими словами риск санкций.
|
Вот что гласит Гугл на этот счет: «Наличие дублированного контента на веб-сайте не является основанием для наложения санкций, если лишь не выясняется, что за сиим стоит намерение одурачить и манипулировать плодами поисковой машины. Если ваш веб-сайт содержит дублированный контент, и вы не следуете описанным выше советам, мы без помощи других выберем версию контента для показа в поисковой выдаче». |
А вот что молвят специалисты в данной отрасли:
|
Пол Шапиро, глава технического отдела SEO и управления SEO-продуктами в Shopify: «Часто люди заблуждаются насчет дублированного контента. По сути наличие одной либо 2-ух малозначимых страничек, содержащих дублированный контент, не так жутко. Настоящая угроза возникает, когда веб-сайт генерирует бессчетный дублированный контент из-за нехороший веб-разработки и технических заморочек SEO. Это может привести к сложностям со сканированием и трафиком на веб-сайте. Вызывают опасение и ситуации, когда иной домен ворует ваш контент и эти странички ранжируются выше ваших. Схожее происходит изредка, но бывает. И в конце концов, пожалуй, самый большенный недочет дублированного контента заключается в разбавлении оборотных ссылок. Если у меня есть две версии одной странички и юзеры не знают, какая из их является главный, то одна может получить оборотные ссылки, а иная нет. Таковым образом, заместо одной странички со всеми оборотными ссылками она будет разбита на две либо наиболее страничек. Это вредоносно для веб-сайта». Патрик Стокс, технический SEO-специалист: «25–30% веб-контента является дублированным, и в этом нет ничего отвратительного! Вас никто не накажет за это, и Гугл решит трудности с дублированием на веб-сайте. Я бы не стал из-за этого очень переживать, если, естественно, речь не идет о преднамеренной краже чужого контента, что может привести к суровым дилеммам». |
Как почаще всего решают делему дублированного контента
Почти всегда наилучшим решением трудности дублированного контента является 301-редирект с нецелевых версий URL-адресов на мотивированные.
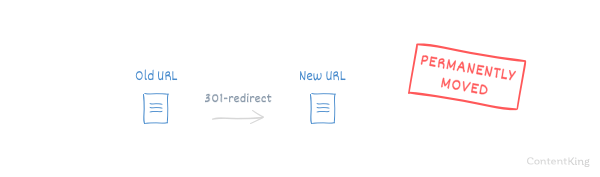
Редирект-301: контент перемещен навечно
Если URL-адреса должны оставаться доступными для гостей, употреблять редирект уже недозволено. Тут на помощь придут или канонические теги, или директива robots noindex. Канонический URL дозволяет соединять воединыжды сигналы, как директива robots noindex – нет.
Кропотливо выбирайте средство для борьбы с дублированным контентом, так как они все имеют свои достоинства и недочеты. В этом случае нет всепригодного подхода, который автоматом избавил бы все трудности.
Почему возникает дублированный контент
Обычно, дублированный контент возникает из-за неправильной опции веб-сервера либо веб-сайта. Это технические трудности, которые, быстрее всего, никогда не приведут к штрафу от Гугл. Тем не наименее они могут нанести суровый вред рейтингу веб-сайта в выдаче.
Кроме заморочек технического нрава, есть и те, которые были вызваны при участии человека – речь о преднамеренно скопированном контенте. Как было сказано ранее, если в схожих действиях есть злой умысел, это может повлечь за собой санкции от ПС.
Технические предпосылки
1. Веб-сайт с www vs без и HTTP vs HTTPs
Представим, что вы используете поддомен www и HTTPs-соединение. Тогда желательный метод представления контента будет смотреться последующим образом:
https://www.example.com.
Это ваш канонический домен.
Если веб-сервер плохо настроен, содержимое веб-сайта также быть может доступно по иным доменам:
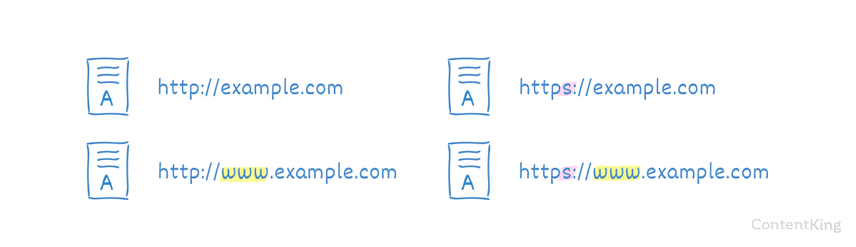
Дублирование контента из-за различных канонических доменов
Все эти домены для Гугл и остальных ПС – различные веб-сайты. При всем этом на их один и этот же контент.
Изберите желательный метод представления контента юзеру и внедрите редирект-301 для ненужных методов. Они должны вести к предпочтительной версии:
https://www.example.com
2. Структура URL: регистрозависимость и оканчивающий слеш
В Гугл URL-адреса чувствительны к регистру. Это значит, что https://example.com/url-a/ и https://example.com/url-A/ рассматриваются как различные URL.
При разработке ссылок просто допустить опечатку, что приведет к индексации обеих версий URL. При всем этом в Bing, к примеру, URL-адреса нечувствительны к регистру. А Yandex тоже чувствителен к регистру URL.
Косая черта (/) в конце URL-адреса именуется оканчивающим слешем. Нередко URL-адреса доступны через оба варианта: https://example.com/url-a и https://example.com/url-a/.
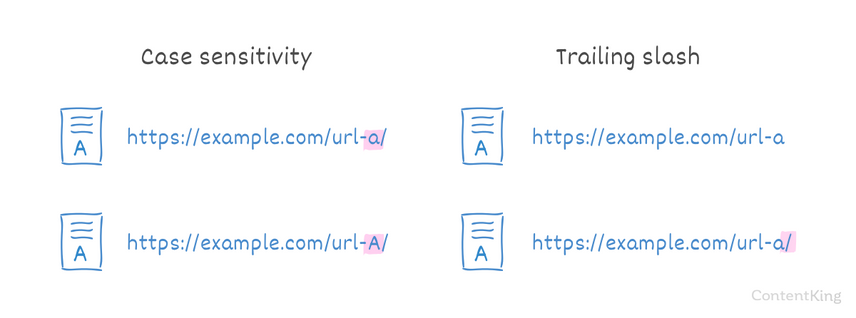
Дублированный контент, вызванный несоответствием в регистре URL-адресов и внедрением оканчивающей косой черты
Изберите предпочтительную структуру для собственных URL-адресов, а для непредпочтительных – реализуйте 301-редирект на предпочтительную версию.
|
Гамлет Батиста, генеральный директор RankSense: «Объединение дублированного контента – это не вопросец о том, как избежать санкций Гугл. Речь о разработке ссылок. Ссылки очень важны для SEO-производительности, но если они оказываются на дублированных страничках, то не принесут никакой полезности, а просто пропадут даром». |
3. Индексные странички (index.html, index.php)
Домашняя страничка вашего веб-сайта быть может доступна через огромное количество URL-адресов. А все дело в неверной конфигурации веб-сервера. Кроме https://www.example.com, она быть может также доступна через:
-
https://www.example.com/index.html
-
https://www.example.com/index.asp
-
https://www.example.com/index.aspx
-
https://www.example.com/index.php
Сделайте 301-редирект от всех нецелевых версий на мотивированную. Если все эти адреса употребляются для предоставления контента, то канонизируйте эти странички.
4. Характеристики для фильтрации
Интернет-сайты нередко употребляют в URL-адресах характеристики, чтоб обеспечить функциональность фильтрации. Возьмем, например, последующий URL:
https://www.example.com/toys/cars?colour=black
На данной страничке отобразятся все темные игрушечные машины.
В то время как юзеров устраивает итог на данной страничке, у ПС могут появиться огромные трудности. Характеристики фильтрации нередко делают фактически нескончаемое количество композиций, когда доступно наиболее 1-го варианта фильтрации. Еще характеристики можно поменять местами.
По сиим двум URL-адресам юзеры увидят полностью схожий контент:
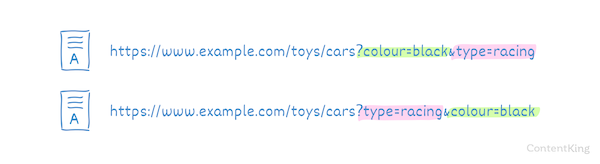
Дублирование контента из-за различного порядка характеристик URL
Внедрите канонические URL-адреса – по одному для каждой главной странички – для предотвращения дублирования контента и укрепления авторитета странички, прошедшей фильтр.
Лишь направьте внимание: это не защитит вас от растраты краулингового бюджета. В качестве кандидатуры можно употреблять функциональность обработки характеристик в Гугл Search Console и Bing Webmaster Tools, чтоб проинструктировать краулеры о том, как работать с параметрами.
|
Дженни Халас, управляющий SEO в LL Flooring: «Дублирование контента – это более всераспространенная и непонятая SEO-проблема. Существует такое огромное количество форм дубликатов, которых следует остерегаться. И мельчайшая техно ошибка может привести к практически тыщам дублированных страничек. Мне приходилось следить, как удачные веб-сайты оказывались в тупике из-за дублированного контента. Одно лишь устранение заморочек, приводящих к возникновению дублированного контента, нередко может привести к повышению органического трафика наиболее чем на 20%. Если ваш веб-сайт посещают миллионы юзеров, то это может принести сотки тыщ баксов доп доходов». |
5. Таксономии
Таксономия – механизм группировки для систематизации контента. Он нередко употребляется в системах управления контентом для поддержки категорий и тегов.
Представим, у вас есть запись в блоге, относящаяся к трем категориям. Запись быть может доступна во всех 3-х категориях:
-
https://www.example.com/category-a/topic/
-
https://www.example.com/category-b/topic/
-
https://www.example.com/category-c/topic/
В этом случае необходимо избрать одну из этих категорий в качестве главной, а другие канонически привязать к ней, используя канонический URL.
|
Давид Иванов, директор отдела поиска в Reckitt: «Дубликаты – это суровая неувязка для почти всех устаревших платформ, которые очень зависят от характеристик внутренней структуры страничек. Но это также и неувязка новейших платформ, таковых как WordPress, с тегами и страничками, которые нередко лучше не регистрировать с самого начала». |
6. Особые странички для изображений
Некие CMS делают отдельную страничку для всякого изображения. На данной страничке нередко просто отображается изображение и больше ничего. Так как на страничке нет другого контента, она весьма похожа на все другие странички с изображениями. ПС лицезреют ее как дублированный контент.
Если это может быть, отключите функцию выделения особых страничек для изображений. Если таковой способности нет, то идеальнее всего добавить атрибут meta robots noindex на такие странички, чтоб ПС их не индексировали.
7. Странички объяснений
Если у вас на сайте включены комменты, вы сможете автоматом разбивать их на странички по истечении определенного времени. Странички с постраничными комментами будут показывать оригинальное содержимое, лишь комменты понизу будут различаться.
К примеру, URL-адрес статьи, в какой показаны комменты 1–20, быть может таковым:
https://www.example.com/category/topic/,
https://www.example.com/category/topic/comments-2/ – для объяснений 21–40
https://www.example.com/category/topic/comments-3/ – для объяснений 41–60.
Используйте связи ссылок с пагинацией, чтоб указать, что это серия страничек с пагинацией.
8. Локализация и атрибут hreflang
Когда идет речь о локализации страничек для различных аудиторий, тоже могут появиться трудности с дублированием контента – когда вы используете один и этот же контент для людей в различных регионах, говорящих на одном и том же языке.
К примеру, у вас есть веб-сайт, направленный на канадский рынок, и веб-сайт для рынка США (Соединённые Штаты Америки — государство в Северной Америке). Так как оба представлены на британском языке, существует высочайшая возможность дублированного контента.
Гугл отлично это описывает и, обычно, сам сводит эти результаты воедино. Атрибут hreflang помогает предотвращать дублирование контента. Потому, если у вас один и этот же контент для разной аудитории, непременно используйте атрибут hreflang в рамках интернациональной SEO-стратегии.
9. Индексируемые странички поисковых результатов
Почти все веб-сайты разрешают юзерам производить поиск по содержимому. Все странички, на которых показываются поисковые результаты, весьма похожи меж собой и почти всегда не несут никакой ценности для поисковых машин. Чуть ли для вас захочется, чтоб они индексировались поисковиками.
Предупредить индексацию страничек с плодами поиска можно методом использования атрибута meta robots noindex. И совершенно идеальнее всего не ссылаться на странички с плодами поиска.
В случае огромного количества страничек с плодами поиска, сканируемых поисковыми машинами, рекомендуется сначала запретить поисковикам доступ к ним, используя файл robots.txt.
10. Индексируемая промежная/тестовая среда
Также рекомендуется употреблять промежные среды для развертывания и тестирования новейших функций на сайтах. Но их нередко неверно оставляют доступными для поисковых машин.
Используйте HTTP-аутентификацию, чтоб закрывать доступ к промежным/тестовым средам. Доп преимущество этого метода еще в том, что вы так закрываете доступ к веб-сайту и жуликам.
11. Контент на стадии разработки
Создавая новейшую страничку с маленьким количеством контента, сохраните ее, но не публикуйте. Часто она не представляет особенной ценности.
Сохраняйте незавершенные странички как черновики. Если для вас вправду нужно опубликовать странички с недостающим содержанием, воспретите поисковым системам регистрировать их – используйте атрибут meta robots noindex.
12. Характеристики, которые употребляются для отслеживания (UTM-метки)
Характеристики в URL также нередко употребляются в целях отслеживания. К примеру, при публикации URL-адресов в Twitter к URL-адресу добавляется источник в виде UTM. Такие характеристики в URL-адресах тоже ведут к созданию дублей. К примеру, вот так будет смотреться URL-адрес, размещенный в Twitter с помощью Buffer:
https://www.contentkingapp.com/academy/ecommerce-link-building/?utm_content=buffer825f4&utm_medium=social&utm_source=twitter.com&utm_campaign=buffer
Чтоб избежать дублей в этом случае, необходимо внедрять канонические URL-адреса с автореферентными ссылками на такие странички.
13. Идентификаторы сессий
Сессии могут хранить информацию о гостях для веб-аналитики. Если к любому URL-адресу, который запрашивает гость, добавляется идентификатор сессии, это приводит к возникновению огромного количества дублированного контента, так как содержимое этих URL-адресов идентично.
Когда вы перебегайте по ссылке на локализованную версию веб-сайта, в нее добавляется переменная сессии Гугл-аналитики. Это может смотреться так:
https://www.contentking.nl/?_ga=2.41368868.703611965.1506241071-1067501800.1494424269.
Она указывает домашнюю страничку с буквально таковым же содержимым, лишь по другому URL-адресу.
В этом случае наилучшим решением тоже будет ввести на страничках автореферентные канонические URL.
14. Комфортная для печати версия
Когда странички имеют комфортную для печати версию по отдельному URL-адресу, на самом деле, снова есть две версии 1-го и такого же контента. Представьте:
https://www.example.com/some-page/
и
https://www.example.com/print/some-page/.
Реализуйте канонический URL-адрес, ведущий от версии, комфортной для печати, к обыкновенной версии странички.
Копирование контента
-
Мотивированные странички для платного поиска
Платный поиск просит особых мотивированных страничек, нацеленных на определенные главные слова. Мотивированные странички часто являются копиями начальных страничек, которые потом настраиваются на определенные главные слова. Так как эти странички весьма похожи, они делают дублированный контент, если индексируются поисковыми машинами.
Воспретите поисковым системам регистрировать мотивированные странички, внедрив атрибут meta robots noindex. Идеальнее всего не ссылаться на мотивированные странички и не включать их в XML-карту веб-сайта.
- Остальные веб-сайты, копирующие ваш контент
Дублированный контент может также появиться из-за того, что остальные веб-сайты копируют и публикуют ваш контент у себя либо кое-где еще.
В особенности остро эта неувязка стоит, если ваш веб-сайт имеет маленький авторитет домена (Domain Authority, DA), а тот, кто копирует ваш контент, владеет наиболее высочайшим DA. Такие веб-сайты почаще сканируются, и в итоге скопированный контент поначалу сканируется на сайте того, кто скопировал контент. Он может восприниматься ПС как создатель оригинала и занимать наиболее высочайшее положение в выдаче.
Похлопочите, чтоб обладатели остальных веб-сайтов отдавали для вас подабающее, внедрив канонический URL-адрес, ведущий на вашу страничку, и ссылку на вашу страничку. Если они не желают этого созодать, вы сможете выслать запрос DMCA в Гугл либо даже подать в трибунал.
- Копирование контента с остальных веб-сайтов
Копирование контента с остальных веб-сайтов – еще одна форма дублированного контента. Гугл пишет, что наилучший метод совладать с данной неувязкой исходя из убеждений SEO – ссылка на начальный источник в сочетании или с каноническим URL, или с метатегом robots noindex.
Как находить дублированный контент
На собственном веб-сайте
Создатель уникальной статьи ведает о том, как работать с ContentKing, чтоб находить дубли, а мы покажем, как созодать это в Анализе веб-сайта от Топвизора.
-
Запустите Анализ веб-сайта, загрузив нужные URL.
-
Поглядите сводку по проверке, когда анализ завершится. В ней есть несколько пт, которые могут сказать о дублях на веб-сайте:
-
Если не настроены www-редиректы, может быть, веб-сайт показывается по адресу с www и без www. Для ПС это две различные версии веб-сайтов, которые являются дублями.
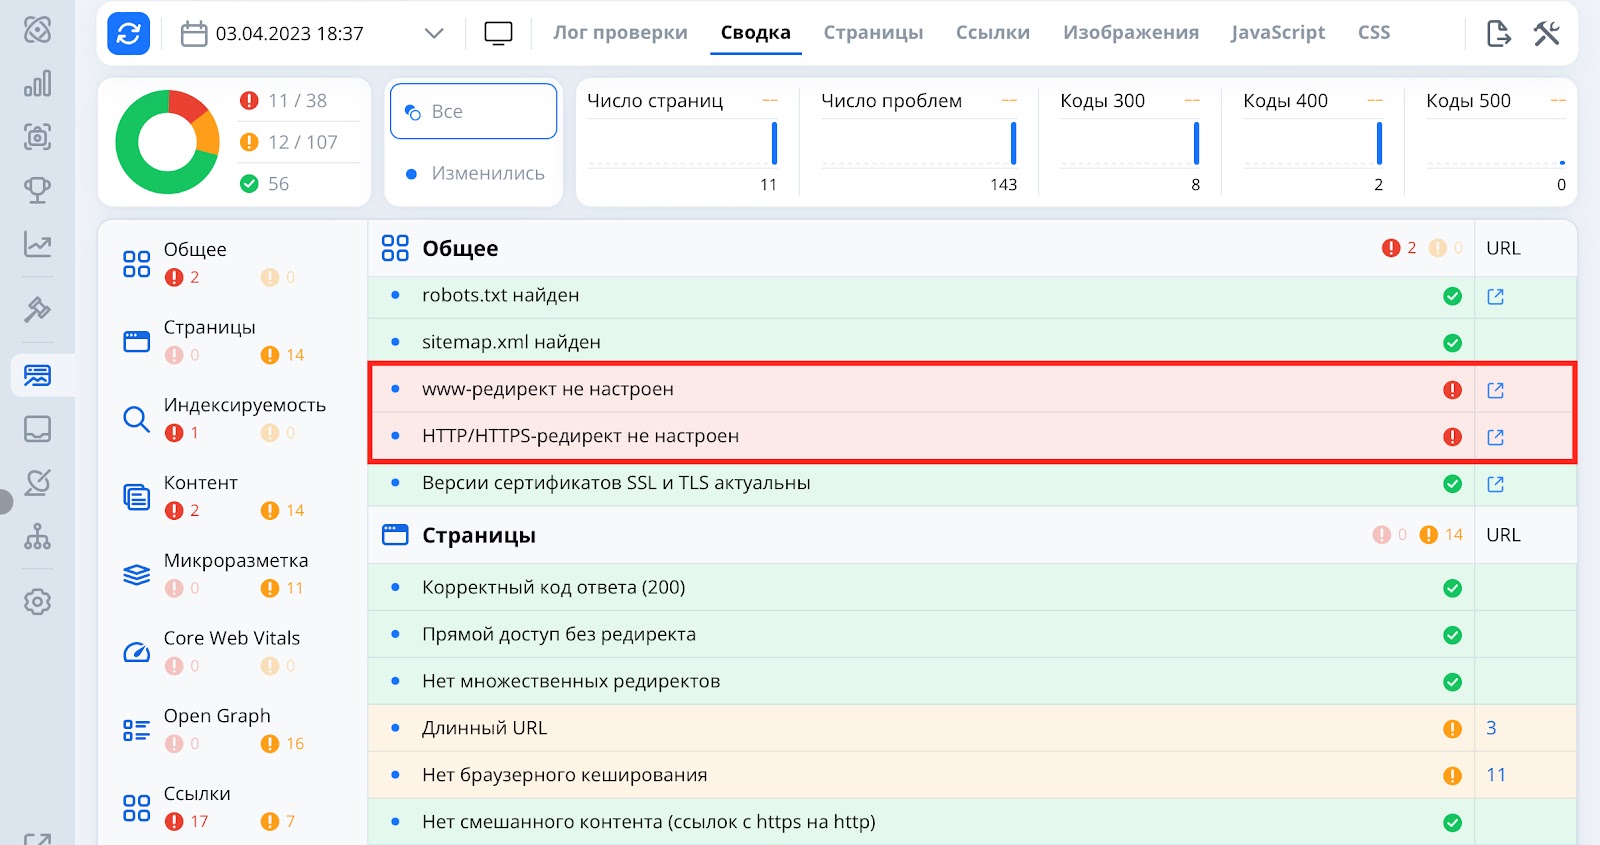
Проверка www и HTTP/HTTPS в Анализе веб-сайта Топвизора
-
В разделе «Индексируемость» можно узреть, есть ли на страничках веб-сайта canonical:

Отчет о индексируемости в сводке «Анализа веб-сайта» в Топвизоре
-
В конце концов, в разделе «Контент» сводки можно узреть, не дублируется ли содержимое тегов title и description на страничках веб-сайта:
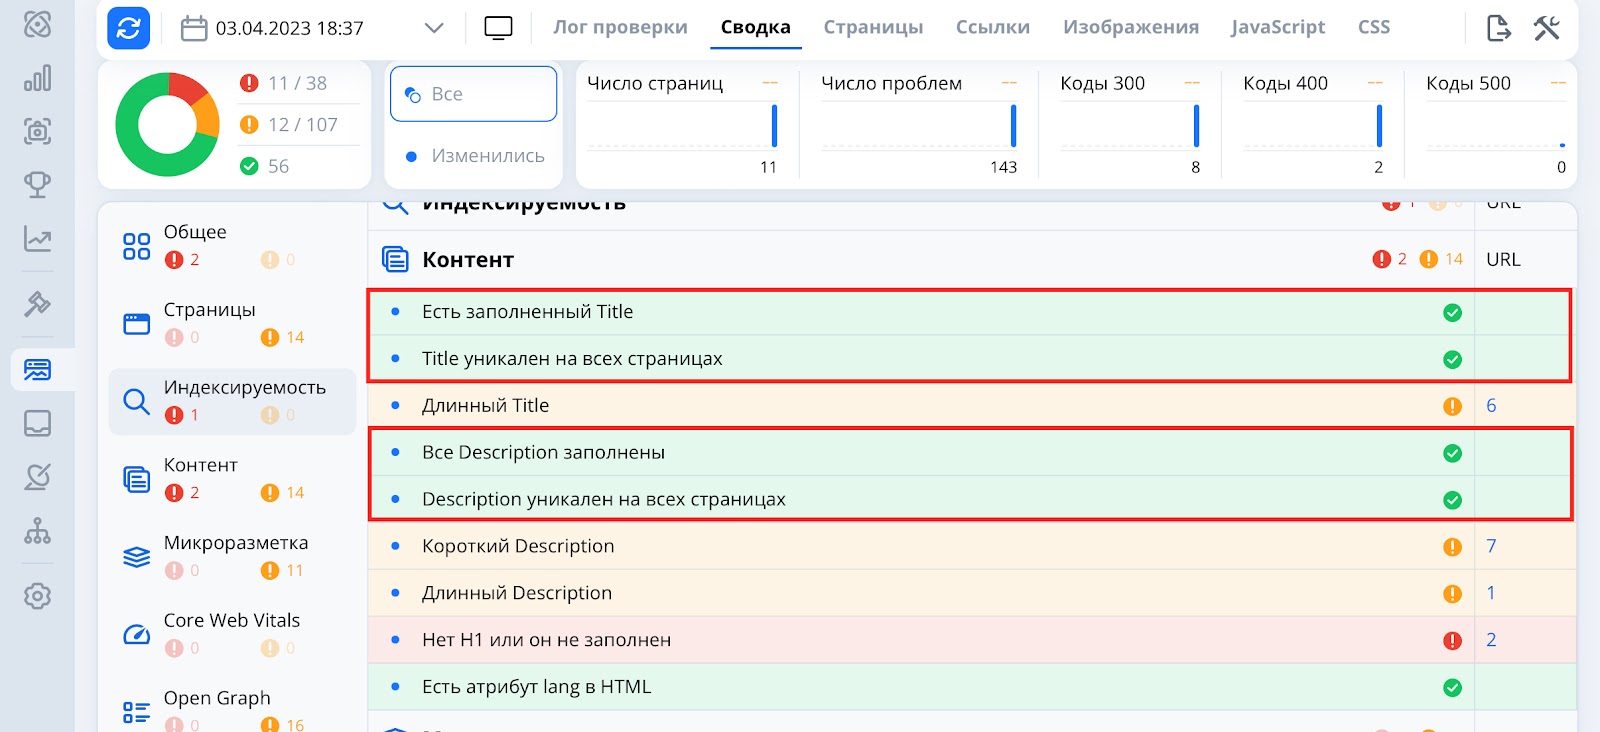
Дубли в Title и Description
Еще дубли title и description можно узреть в отчете «Странички» – «Контент»:
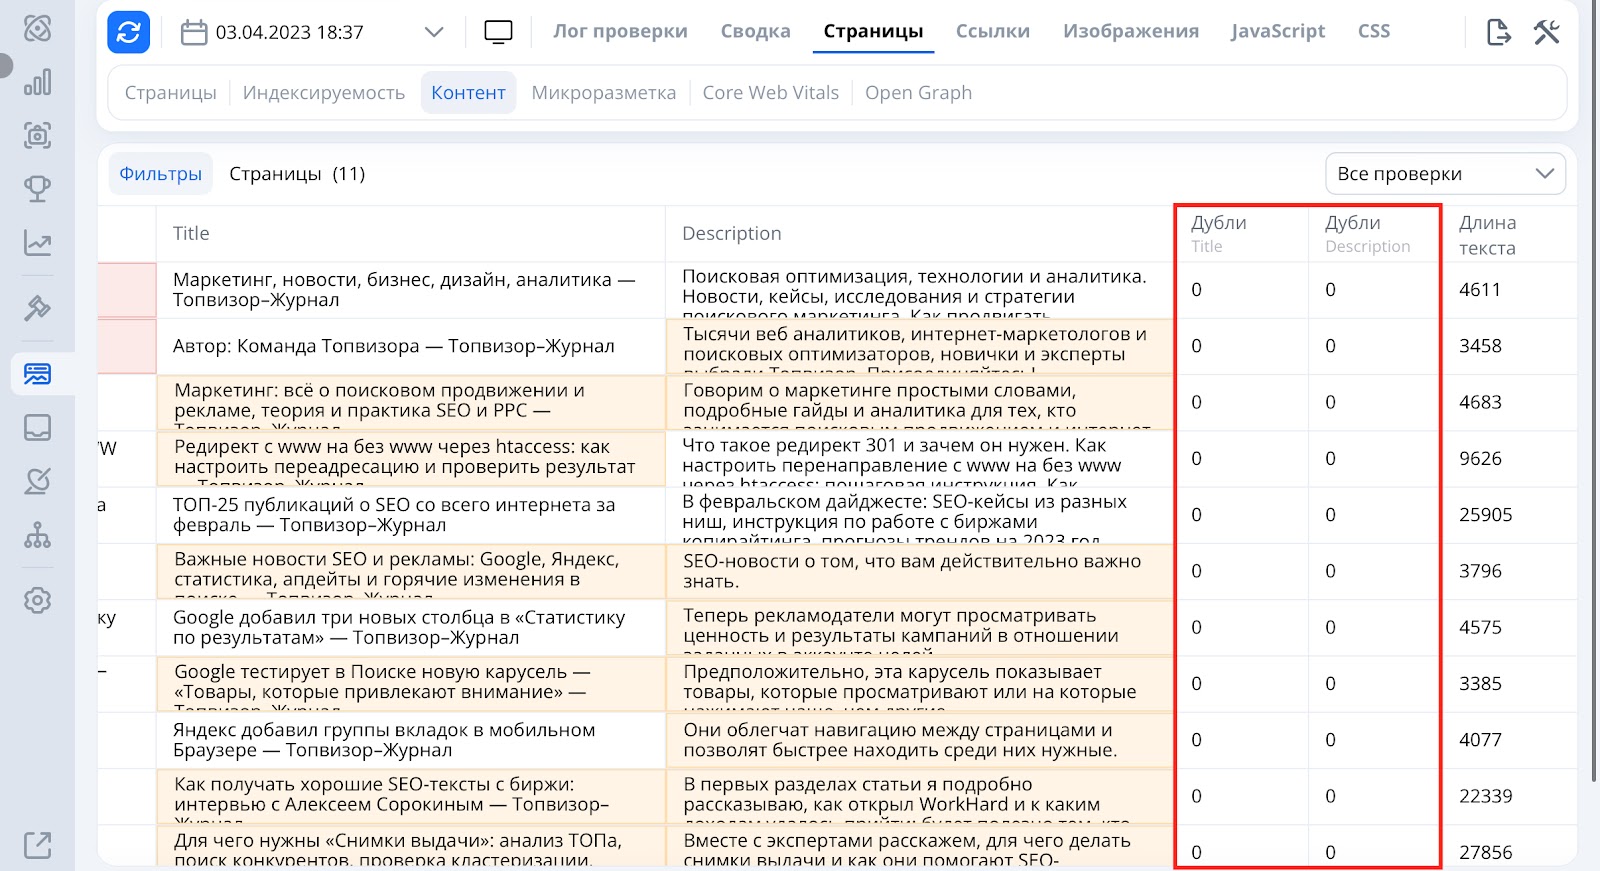
Дубли title и description в Анализе контента
Отчет Гугл Search Console о охвате индекса также понадобится при поиске дублированного контента на веб-сайте. Обращайте внимание на последующие трудности:
-
Дубликат, юзер не выбирал каноническую страничку: Гугл нашел дубликаты URL-адресов, которые не канонизированы до предпочтительной версии.
-
Дубликат странички, Гугл избрал страничку заместо той, что избрал юзер: Гугл решил проигнорировать ваши канонические URL-адреса, которые он без помощи других отыскал, и заместо этого присваивает избранные Гугл странички.
-
Дубликат, представленный URL, не избран в качестве канонического: Гугл решил проигнорировать канонические странички, которые вы обусловили для URL-адресов, отправленных вами через XML-карту веб-сайта.
В Веб-мастере тоже можно узреть эти данные – в отчетах вкладки «Индексирование».
На остальных веб-сайтах
Если у вас небольшой веб-сайт, вы сможете испытать выискать в Гугл фразы в кавычках. К примеру:
Используя ContentKing, вы с легкостью отыщите дублирующийся контент, проверив, есть ли на ваших страничках неповторимое заглавие, метаописание, и заголовок H1.
Введя схожую фразу в поиск, можно узреть дубли.
В качестве кандидатуры для огромных веб-сайтов можно употреблять Copyscape. Он просматривает интернет-страницы в поисках нескольких повторений 1-го и такого же либо практически схожего содержимого.
FAQ по дублированному контенту
Могут ли на веб-сайт наложить санкции за дублированный контент
Если у вас не было целей вполне копировать чей-то веб-сайт, то, быстрее всего, на вас не наложат санкции. Если же вы скопировали огромное количество чужого контента, то таковой риск есть.
|
Вот что гласит Гугл на этот счет: «Дублированный контент на веб-сайте не является основанием для действий в отношении этого веб-сайта, если лишь не выясняется, что за дублированным контентом стоит намерение одурачить и манипулировать плодами поисковой машины. Если ваш веб-сайт содержит дублированный контент и вы не следуете описанным выше советам, мы без помощи других выберем версию контента для показа в поисковой выдаче». |
Повысит ли устранение заморочек с дублированным контентом рейтинг веб-сайта в выдаче
Да, устраняя трудности с дублированием контента, вы сообщаете ПС, какие странички вправду следует исследовать, регистрировать и ранжировать.
Вы также не позволите поисковым системам растрачивать краулинговый бюджет на исследование вашего веб-сайта на предмет нерелевантных дублированных страничек. Они могут сосредоточиться на неповторимом контенте, по которому вы желаете ранжироваться.
Какое количество дублированного контента на веб-сайте допустимо
На этот вопросец нет единственно правильного ответа. Но если вы желаете повысить рейтинг странички, она обязана быть ценной для ваших гостей и содержать неповторимый контент.