

ETL и датавиз: SEO-аналитика на огромных данных. Чемодан
Всем привет, на связи JetStyle.Promo. В этом кейсе мы рассказываем, как сделали ETL и систему дашбордов, решающую делему анализа огромных размеров данных для контроля и увеличения эффективности поискового продвижения веб-сайта, осложненного из-за сэмплирования данных.
Основное о кейсе
Наш клиент – Rusprofile – сервис проверки и анализа контрагентов. На портале Rusprofile расположена подробная животрепещущая информация о наиболее чем 10 миллионах русских юридических лиц и 12 миллионах личных бизнесменов. Имея наиболее 500 000 визитов в день, наш клиент столкнулся с дичайшим сэмплированием в Yandex Метрике, которые не дают поглядеть четкие данные наиболее чем за 2 денька.
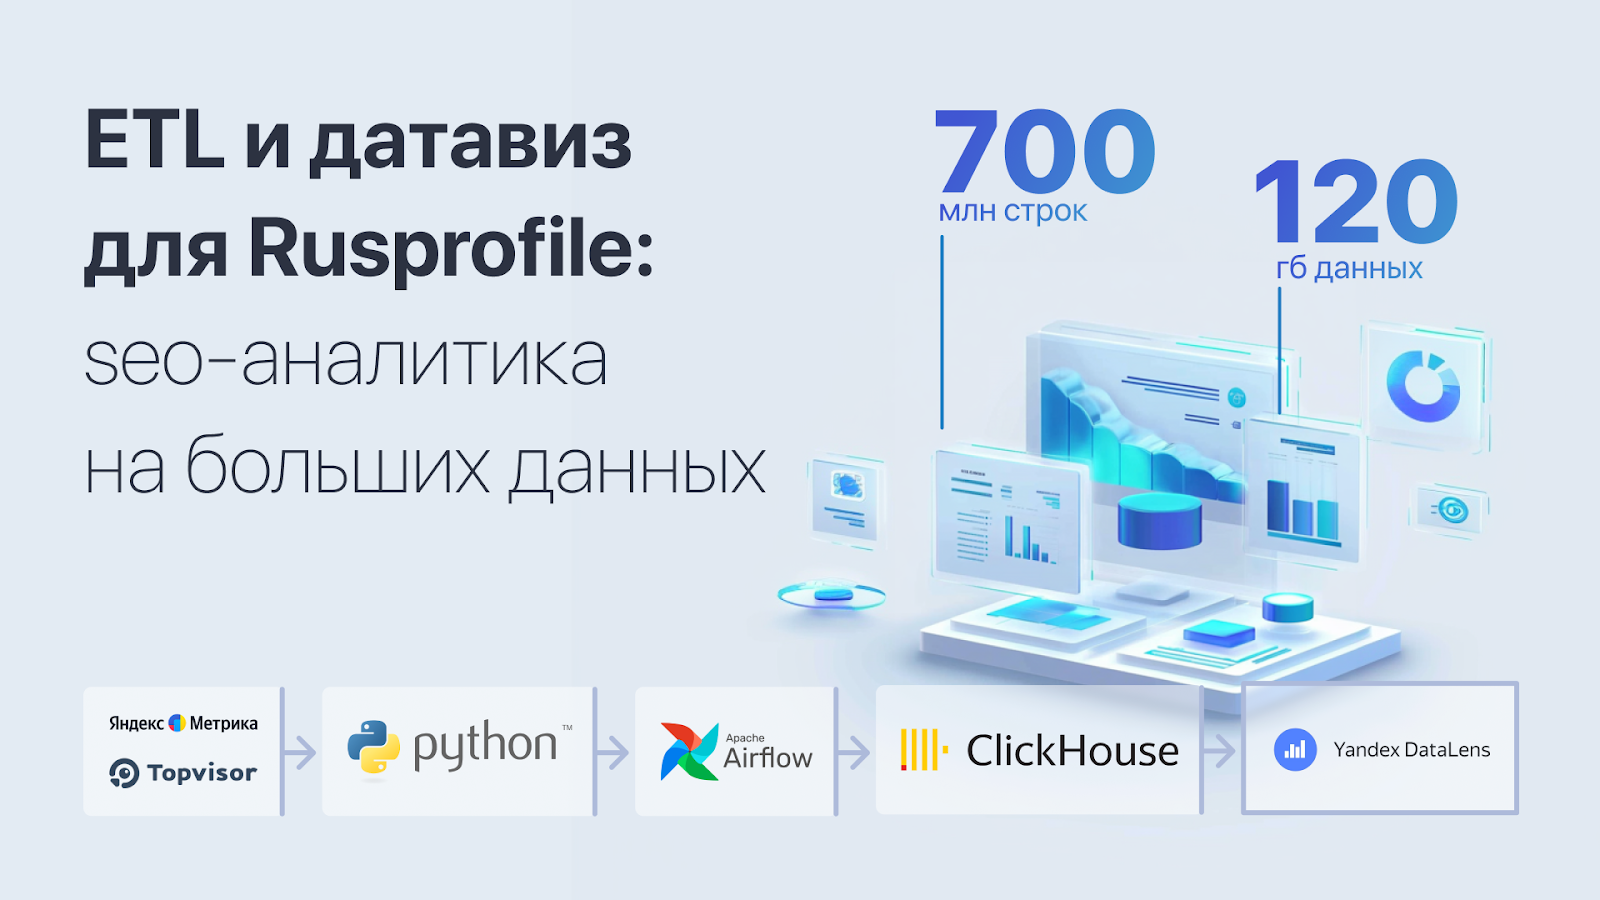
Мы сделали ETL и систему дашбордов, которые решают эту делему (для что на старте обработали наиболее 120 ГБ сырых данных из Yandex Метрики и Топвизора, и в итоге начальная таблица в базе данных содержит наиболее 700 млн строк).
ETL (Extract, Transform, Load) – это трехэтапный процесс управления данными, в дословном переводе означает «извлечение, преобразование, загрузка».
Сейчас:
-
издержки на настройку системы визуализации окупились еще в августе;
-
мы экономим для клиента по 300 000 рублей каждый месяц, исключив необходимость подключения Метрики Про для доступа к несэмплированным данным;
-
за счет своей системы хранения и обработки данных обеспечиваем неизменный доступ ко всему массиву инфы.
Сэмплирование – процесс подборки части данных для анализа, используемый для понижения перегрузки на систему.
Бизнес-задача и ее решение
Неувязка
Сложность анализа огромных размеров данных для контроля и увеличения эффективности поискового продвижения веб-сайта из-за сэмплирования. Несэмплированные данные доступны в интерфейсе Метрики максимум за две недельки. Чтоб получить наиболее полный доступ, нужно подключать Метрику Про (от 300 тыс. рублей за месяц).
Решение
Создание собственного хранилища данных и визуализация их в дашборде на базе Yandex DataLens.
Цели дашборда
- Мониторинг главных метрик SEO: дозволяет стремительно выслеживать динамику органического трафика и видимость веб-сайта по главным показателям (поисковая машина, группа запросов, смысл запроса в поисковике).
- Принятие решений на базе данных: из-за сэмплирования в Yandex Метрике данные нередко искажены. Дашборд предоставляет незапятнанные, несэмплированные данные для анализа, что упрощает принятие стратегических решений.
- Идентификация точек роста и проблемных зон: дашборд указывает динамику роста по группам запросов и дозволяет оперативно выявлять резкие падения позиций по отдельным группам, что дает возможность вовремя принимать конструктивные меры.
Реализация, технические детали
Основная изюминка проекта – вправду большенный размер данных.
К примеру, выгрузка данных из Yandex Метрики за один месяц содержит около 15 млн строк и весит наиболее 3 ГБ, и это при использовании всего 14 полей из всех доступных в Logs API.
Чтоб сохранить доступ к данным, мы употребляли лишь русские и опенсорсные решения:
ClickHouse – для хранения данных, так как эта колоночная СУБД разработана специально для работы с большенными размерами данных.
Airflow – для оркестрации потоков данных.
Yandex DataLens – для визуализации данных, потому что инструмент русский, владеет необходимым функционалом и интенсивно развивается.
Jupyter Notebooks (Python) – для удобства работы с кодом (на базе опыта Netflix: Beyond Interactive: Notebook Innovation at Netflix и Part 2: Scheduling Notebooks at Netflix).
Мы спроектировали структуру датасета и его хранение в базе данных, чтоб:
-
не выгружать излишние данные, которые не будут употребляться;
-
предугадать защиту от дубликации данных при загрузке;
-
защитить процесс загрузки данных от сбоев соединения.
Также мы написали коннекторы к:
-
Logs API Yandex Метрики;
-
API Топвизора.
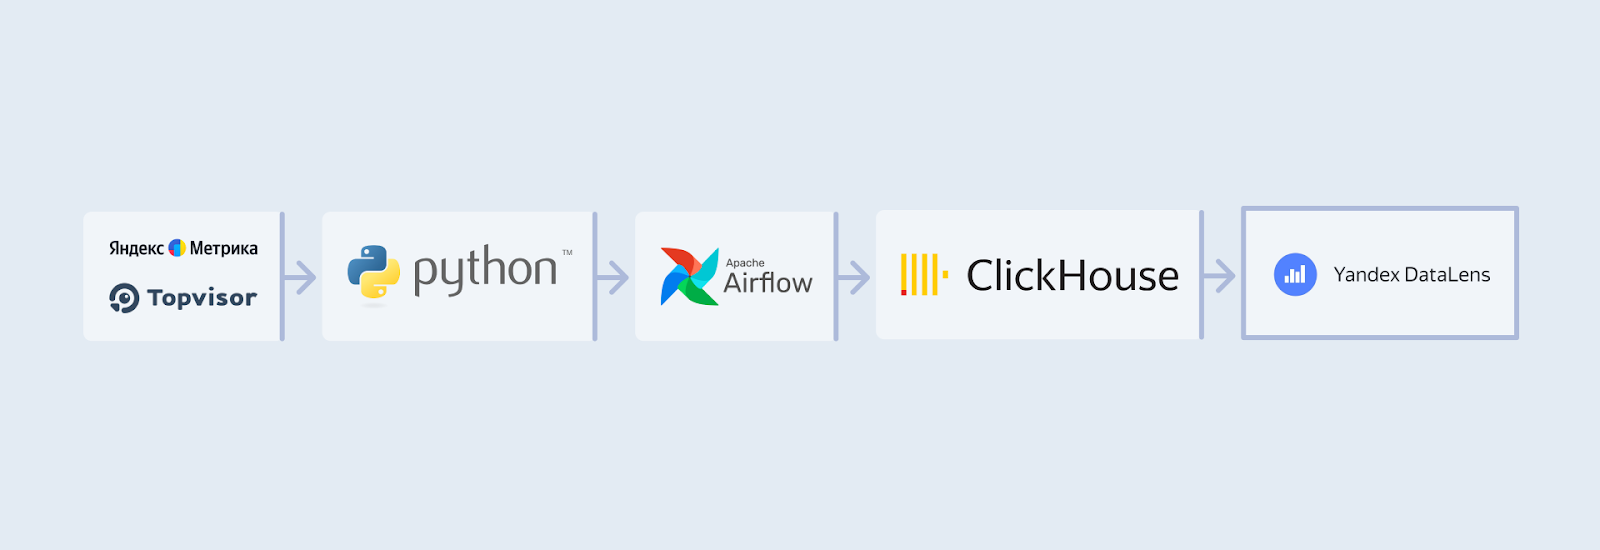
Для обеспечения сохранности и увеличения скорости работы дашборда в базе данных сотворено несколько слоев:
-
временные данные (tmp-слой) – сюда данные загружаются на исходном шаге. В случае обрыва соединения затронуты будут лишь временные таблицы, а основная таблица остается нетронутой;
-
сырые, неагрегированные данные (raw-слой) – сюда данные импортируются из временных таблиц. Добавочно проверяется отсутствие пересечения датасетов, а дата импорта фиксируется для способности отслеживания конфигураций;
-
витрины данных (dwh-слой) – этот слой формируется на базе raw-слоя и содержит агрегированные данные в подходящих срезах. Внедрение витрин понижает нагрузку на базу и ускоряет загрузку чартов в дашборде.
Таковая структура защищает от ошибок и ускоряет работу дашборда.
При загрузке данных мы добавочно обогащаем их, чтоб получить доп срезы, труднодоступные в текущих инструментах:
Для данных из Yandex Метрики
-
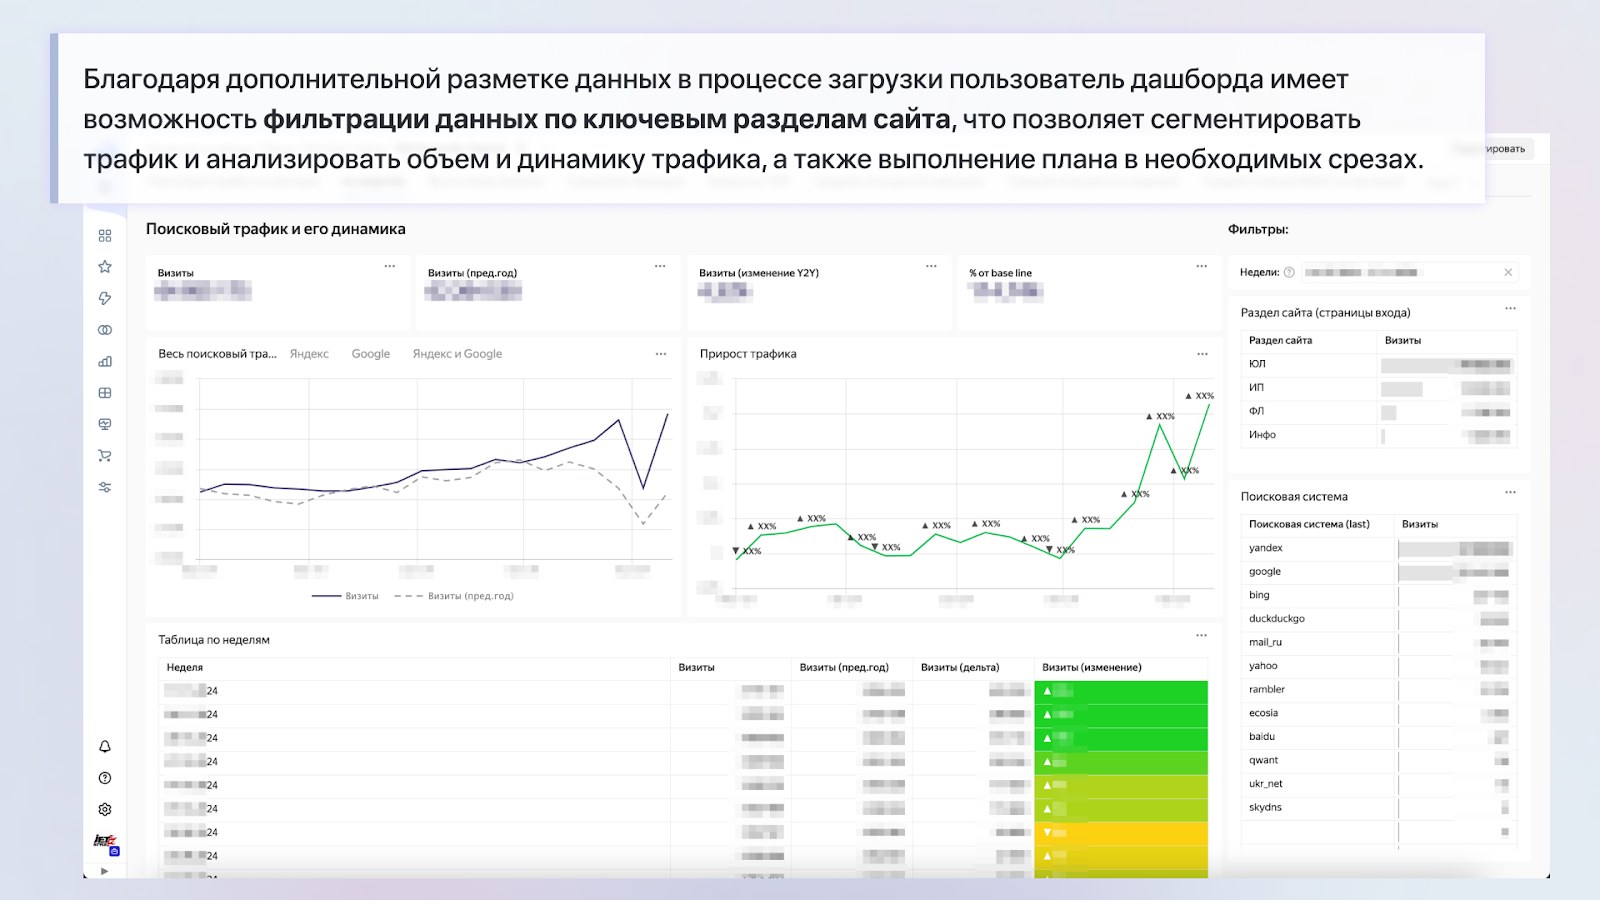
размечаем разделы веб-сайта при помощи постоянных выражений, что дозволяет стремительно фильтровать по главным разделам в дашборде;
-
вычисляем плановые характеристики с персональными коэффициентами для каждой поисковой машины, что дает возможность гибко задавать план по трафику и надзирать его выполнение;
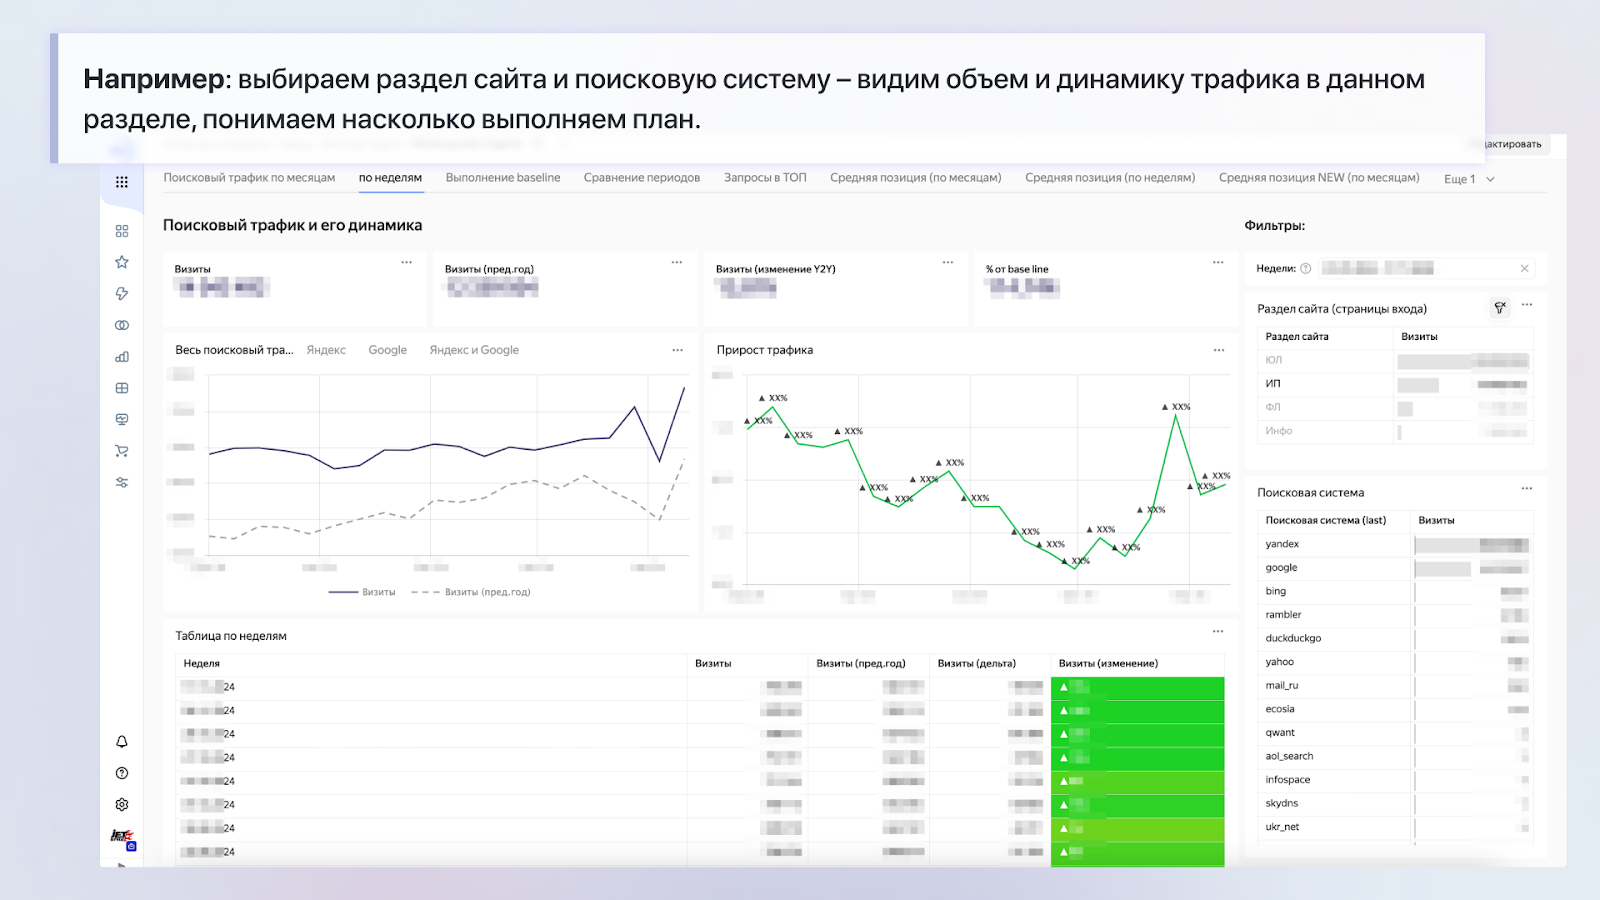
Для данных из Топвизора – размечаем запросы по группам и поисковому интенту на базе словаря в Гугл Sheets, что обеспечивает наиболее гибкую сегментацию в отчетах.
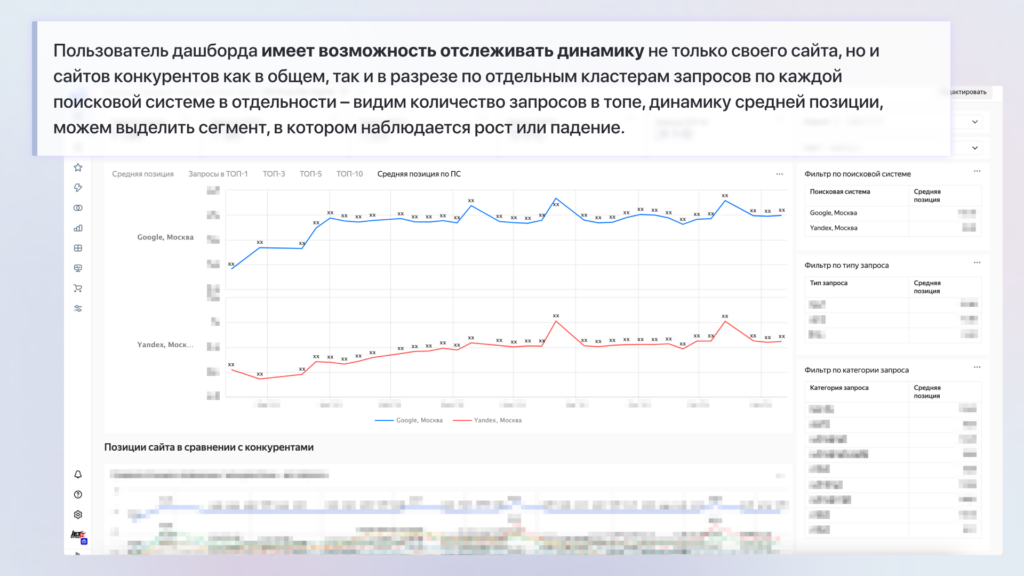
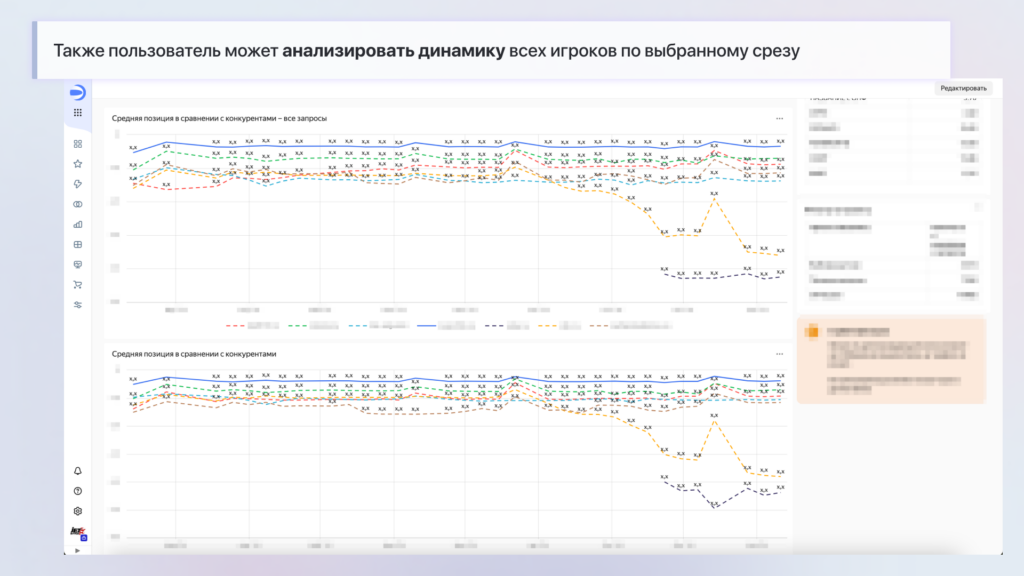
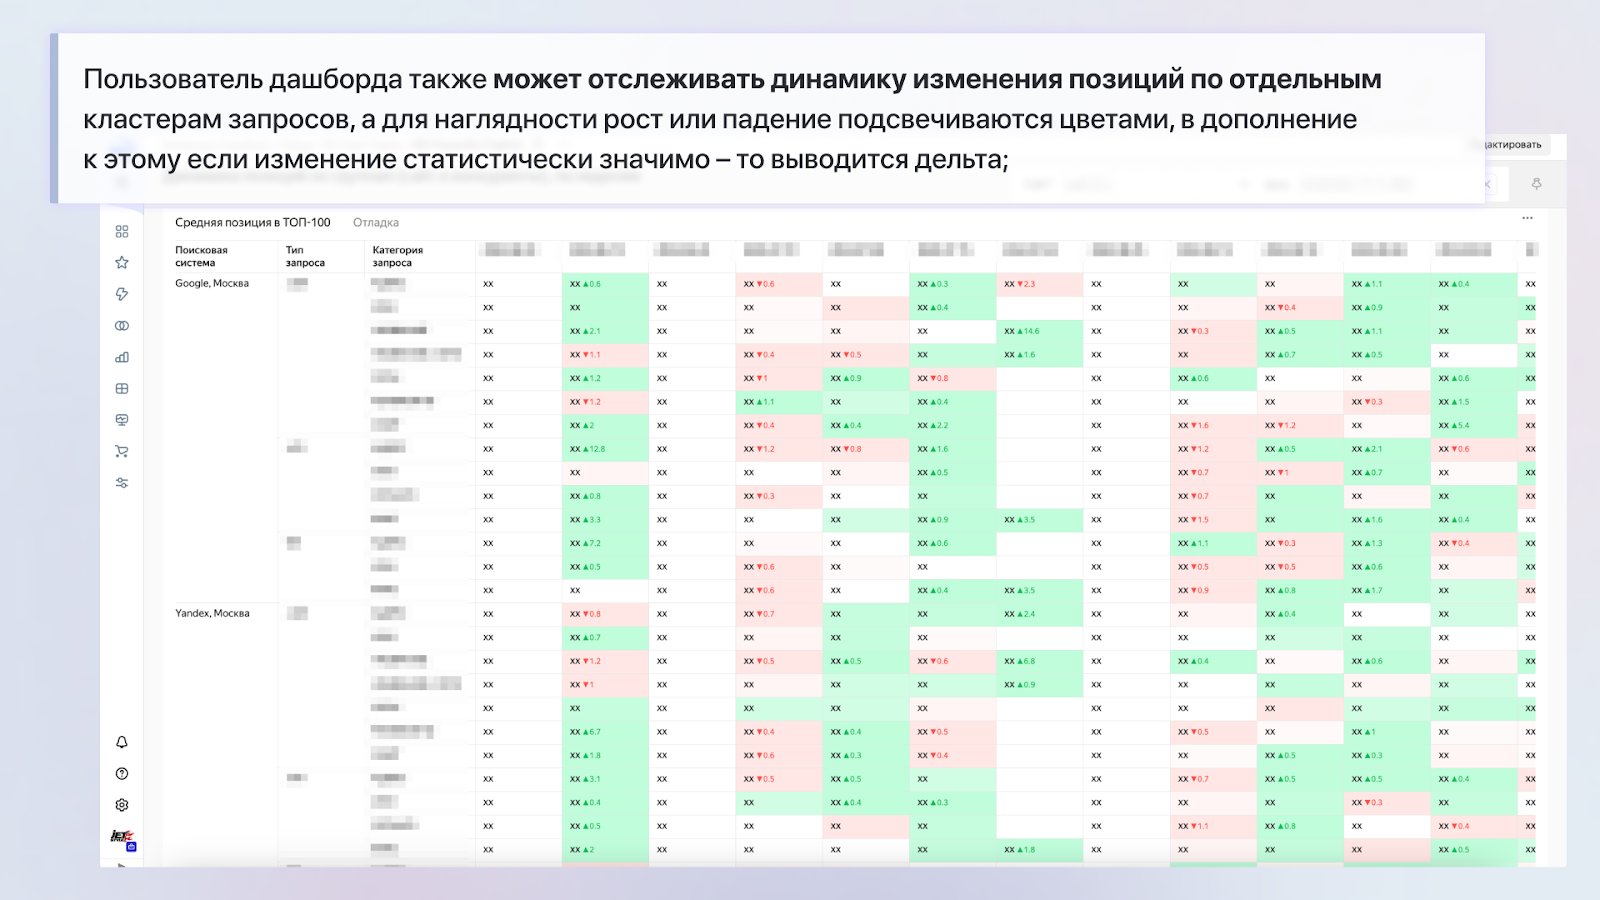
Для обеспечения актуальности данных в отчетах мы разработали пайплайн в Apache Airflow:
-
данные из Yandex Метрики выгружаются раз в день за предшествующий денек и загружаются в базу;
-
по понедельникам пересчитывается агрегация данных о визитах из Yandex Метрики;
-
также по понедельникам выгружаются данные Топвизора за прошедшую недельку и обновляется агрегация;
-
по результатам всех операций в Telegram-чат отправляются извещения о статусе и обновлении выгрузки, а логи хранятся на сервере в формате Jupyter-ноутбуков, что дозволяет просто найти причину сбоя в случае появления ошибки.
Инсайты, догадки, процесс сотворения и взаимодействия с заказчиком
Сам дашборд мы сделали в Yandex DataLens, следуя продуктовой логике:
-
На старте у нас были точное осознание ожиданий заказчика, примерное представление о конечном итоге и принципиальные для него срезы данных.
-
Настроив выгрузку данных из Yandex Метрики, мы сходу реализовали MVP вкладки с данными о посещаемости. Опосля этого в процессе 3–4 итераций мы доработали дашборд: изменили логику расчета план-факта, ввели витрины для увеличения скорости, добавили сопоставление случайных периодов.
-
К моменту работы над вкладкой с позициями заказчик уже получил рабочий инструмент для отслеживания динамики поискового трафика. В процессе разработки вкладка с позициями также перетерпела ряд конфигураций и улучшений.
-
Опосля сотворения каждой вкладки мы проводили кросс-проверку данных, чтоб исключить ошибки в расчетах.
В процессе опции дашборда у нас появлялись достойные внимания заморочки, к примеру:
1. Раздел «план-факт»
Поначалу он рассчитывался раздельно по месяцам и неделькам на уровне DataLens и общей формулы. Позднее сделалось понятно, что необходимы различные коэффициенты для Yandex’а и Гугл. Потому расчеты были перенесены на уровень базы данных, что упростило контроль и повысило скорость загрузки чартов.
2. Позиции в Топвизоре
Мы нашли, что из-за недостающего баланса позиции могут не обновиться. На этот вариант добавили возможность задавать позиции по шаблону для определенного денька и среза в Гугл Sheets – эти данные подхватываются при агрегации и записываются в таблицу.
3. Загрузка датасета с историческими данными из Yandex Метрики
Для данной для нас задачки потребовался стационарный ПК (Персональный компьютер — компьютер, предназначенный для эксплуатации одним пользователем), потому что на MacBook не хватило места на SSD-диске. Мы написали цикл, который целую ночь (то есть темное время суток) загружал данные в базу маленькими частями по 1 млн строк.
4. Нежданные вопросцы
Однажды Сергей Торкунов (наш заказчик) задал вопрос, к примеру, такое: «Сколько страничек необходимо взять из 36 млн, чтоб подборка отражала положение дел с точностью 95%?». Нам временами приходилось освежать познания по теории вероятностей, а в один прекрасный момент даже обратиться к педагогу из института, чтоб убедиться в корректности расчетов.
Работать с человеком, который заходит в топ-20 известнейших SEO-персон, не только лишь трепетно и круто, да и весьма интересно!
5. Развитие дашборда
Пока писали этот чемодан, доработали датасет по позициям на базе новейших вводных. Сейчас в мониторинге еженедельные данные по 515 000 запросов в поисковике, которые можно отфильтровать и по веб-сайту заказчика, и по соперникам. При всем этом у всех будет разбивка по группам и смысловому интенту.