

Как Гугл обрабатывает JavaScript в процессе индексации
Чтоб улучшить веб-сайты для поисковых машин, принципиально осознавать, как поисковые машины делают сканирование, рендеринг и индексацию веб-страниц. С возрастом, когда поисковые машины, такие как Гугл, меняют свои способы работы, тяжело уследить за тем, что работает, а что нет – в особенности в случае с client-side JavaScript.
В SEO-сообществе сохранилось несколько старенькых убеждений про SEO и JavaScript:
-
Гугл не может распознать client-side JavaScript.
-
Гугл по-другому относится к страничкам на JavaScript.
-
Очередность и время рендеринга значительно влияют на SEO.
-
На веб-сайтах с огромным количеством JavaScript странички открываются медлительнее.
Чтоб разобраться с этими утверждениями, Vercel в сотрудничестве с MERJ поэкспериментировали и исследовали поведение Гугл при сканировании JS. Они проанализировали наиболее 100 тыс. операций Googlebot на разных веб-сайтах, чтоб проверить и удостовериться в SEO-возможностях Гугл.
❗️Специалисты из Топвизор-Журнальчика перевели и адаптировали исследование MERJ и Vercel, направленного на исследование рендеринга Гугл при помощи эмпирических данных.
Методология исследования
В процессе использовались инфраструктура Vercel и технологии MERJ Web Rendering Monitor (WRM). Исследование проводилось с 1 по 30 апреля 2024 года на веб-сайте nextjs.org с доп данными с веб-сайтов monogram.io и basement.io.
Сбор данных
На этих веб-сайтах для перехвата и анализа запросов от роботов поисковых машин был установлен пользовательский Edge Middleware. Это промежуточное ПО (то есть программное обеспечение — комплект программ для компьютеров и вычислительных устройств) позволило:
-
идентифицировать и выслеживать запросы от разных поисковых машин и ИИ-краулеров. Данные о юзерах в этот запрос не врубались;
-
вставлять легкую библиотеку JavaScript в HTML-ответы для роботов.
В момент окончания рендеринга странички библиотека JavaScript высылала данные на длительно работающий сервер, включая:
-
URL-адрес странички;
-
неповторимый идентификатор запроса, чтоб сравнить рендеринг странички с обыкновенными журнальчиками доступа сервера;
-
время окончания рендеринга – рассчитывается по времени приема запроса библиотекой JavaScript на сервере.
Анализ данных
Сравнивая начальный запрос, находящийся в журнальчиках доступа к серверу, с данными, отправленными нашим промежным ПО (то есть программное обеспечение — комплект программ для компьютеров и вычислительных устройств) на наружный сервер с beacon, мы можем:
-
найти, какие странички были удачно отображены поисковыми машинами;
-
высчитать разницу во времени меж начальным сканированием и завершенным рендерингом;
-
проанализировать шаблоны обработки разных типов контента и URL-адресов.
Размер данных
Для данной статьи сначала были применены данные Googlebot, который предоставил самый большенный и надежный набор инфы. В анализ было включено наиболее 37 тыс. HTML-страниц, что позволило получить надежную подборку, на базе которой можно созодать нужные выводы.
В истинное время длится сбор данных о остальных поисковых системах, включая ИИ-провайдеров, таковых как OpenAI и Anthropic, и в дальнейшем планируется поведать о новейших результатах.
В последующих разделах разглядим любой миф и по мере необходимости приведем наиболее подробную статистику.
Эволюция способностей рендеринга Гугл
За прошедшие годы способности Гугл по сканированию и индексации веб-контента существенно поменялись. Наблюдение за данной динамикой принципиально для осознания текущего состояния SEO для современных веб-приложений.
До 2009 года: ограниченная поддержка JavaScript
На заре развития Гугл регистрировал в главном статический HTML-контент. Контент, сделанный на JavaScript, был фактически невидим для поисковых машин. Это привело к широкому использованию для SEO-целей конкретно статического HTML.
2009–2015 годы: схема сканирования AJAX
Гугл представил схему сканирования AJAX, позволяющую сайтам передавать снимки HTML из динамически генерируемого контента. Это было временное решение, которое добивалось от разрабов создавать отдельные версии собственных страничек, подходящих для просмотра.
2015–2018 годы: ранешний рендеринг JavaScript
Гугл начал рендеринг страничек в Chrome Headless, тем сделав значимый шаг вперед. Но эта древняя версия браузера все еще имела ограничения в обработке современных функций JS.
2018 год: истинное время и современные способности рендеринга
Сейчас Гугл употребляет для рендеринга освеженную версию Chrome, идущую в ногу с новыми веб-технологиями. Главные нюансы текущей системы включают:
-
Всепригодный рендеринг. Сейчас Гугл пробует показать все HTML-страницы, а не только лишь их часть.
-
Современный браузер. Googlebot употребляет последнюю размеренную версию Chrome/Chromium, поддерживающую современные функции JS.
-
Stateless-рендеринг. Любой рендеринг странички происходит в новейшей сессии браузера, не сохраняя cookie-файлы либо состояние прошлых рендеров. Гугл, обычно, не перебегает по элементам на страничке, таковым как содержимое вкладок либо баннеры с куки.
-
Клоакинг. Гугл воспрещает демонстрировать юзерам и поисковым системам разный контент для манипулирования рейтингом.
❗️ Не используйте код, который изменяет содержимое зависимо от User-Agent. Заместо этого оптимизируйте для Гугл рендеринг вашего приложения без статических данных и реализуйте персонализацию при помощи способов, учитывающих состояние.
-
Кеширование ассетов. Гугл ускоряет рендеринг веб-страниц за счет кеширования ассетов, а это полезно для страничек с общими ресурсами и для повторных рендерингов одной и той же странички.
Заместо использования заголовков HTTP Cache-Control служба веб-рендеринга Гугл применяет свою внутреннюю эвристику, чтоб найти, как свежайши кешированные ассеты и когда их необходимо загрузить опять.
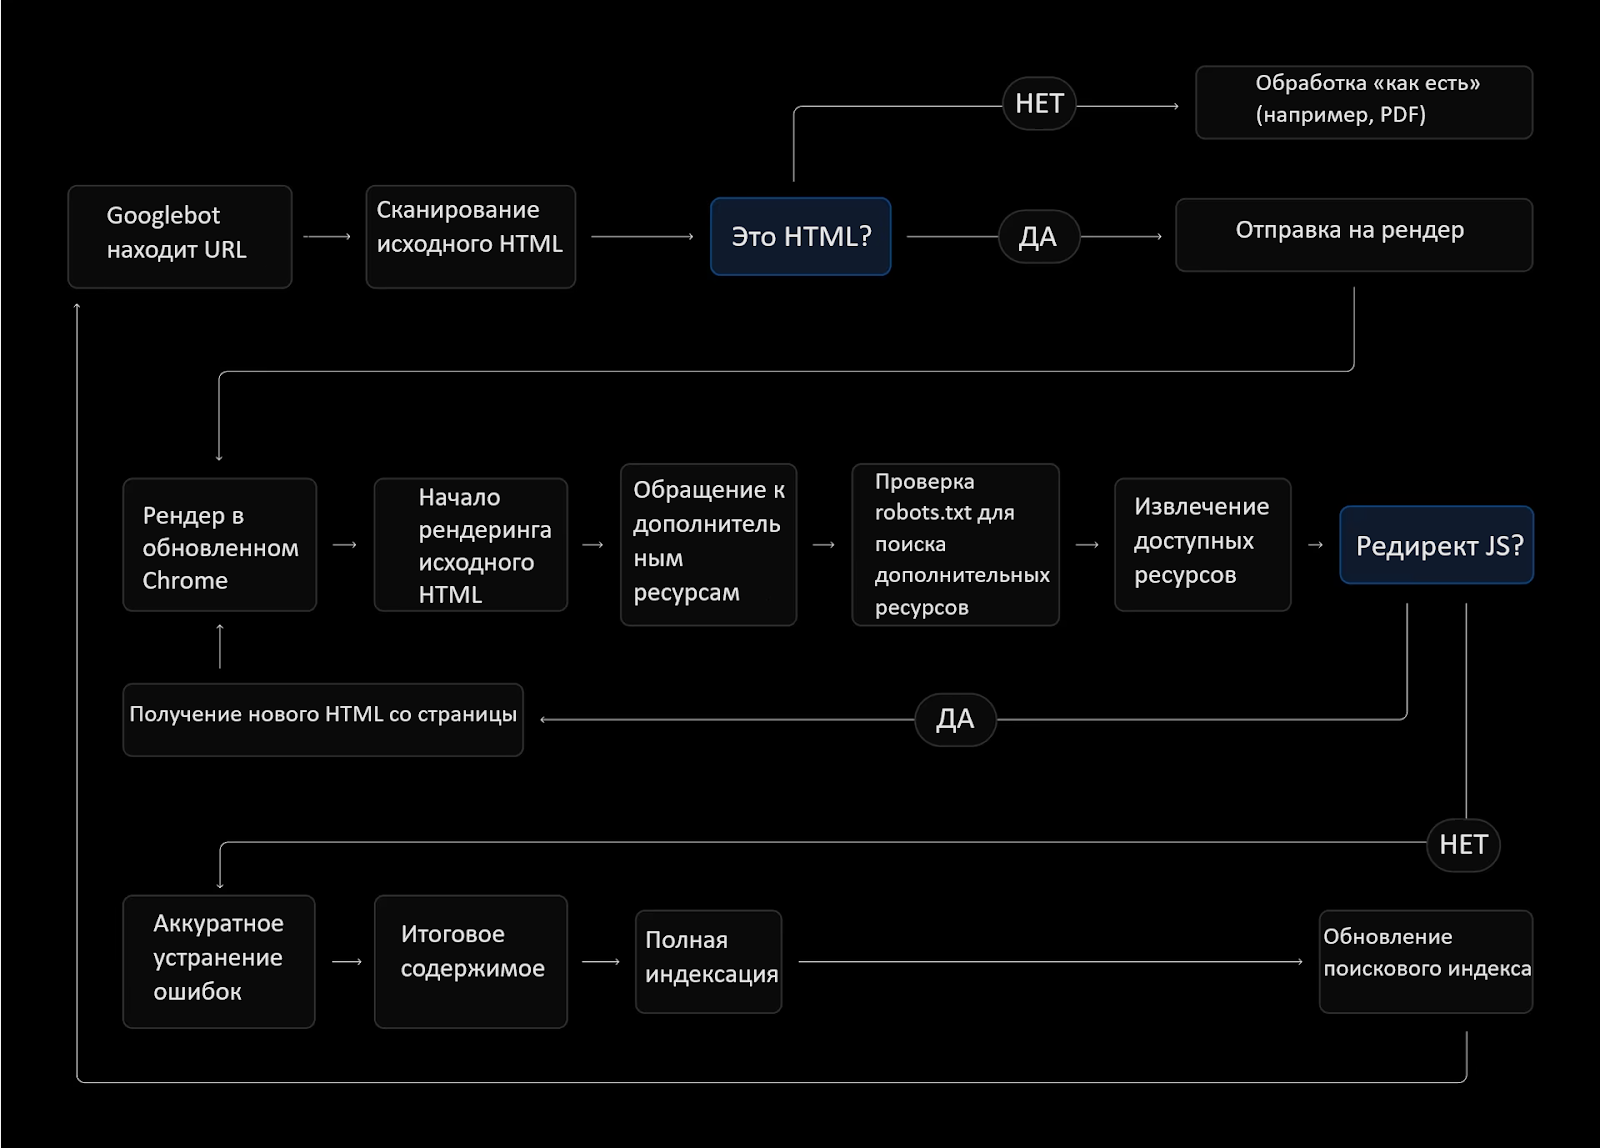
На данный момент процесс индексации в Гугл смотрится приблизительно так
Чтоб лучше осознать, на что способен Гугл, давайте разглядим некие всераспространенные легенды и то, как они влияют на SEO.
Миф №1: Гугл не умеет обрабатывать JavaScript-контент
Этот миф принудил почти всех разрабов избегать JS-фреймворков либо прибегать к сложным обходным путям для SEO.
Тестирование идеи
Чтоб проверить способность Гугл показывать JavaScript-контент, Vercel и MERJ сосредоточились на 3-х главных качествах:
-
Сопоставимость с JS-фреймворками. Они проанализировали взаимодействие Googlebot с Next.js, используя данные с веб-сайта nextjs.org, который употребляет сочетание статического пререндеринга, server-side и client-side-рендеринга.
-
Индексирование динамического контента. Исследовали странички на nextjs.org, загружающие контент асинхронно через воззвания к API. Это позволило найти, может ли Googlebot обрабатывать и регистрировать контент, не присутствующий в начальном HTML-ответе.
-
Потоковый контент через составляющие React Server Components (RSC). Как и в прошлом случае, большая часть веб-сайта nextjs.org построена с внедрением Next.js App Router и RSC. Отлично видно, как Googlebot обрабатывает и регистрирует контент, равномерно передаваемый на страничку.
-
Коэффициент удачливости рендеринга. В исследовании сравнили количество запросов Googlebot в журнальчиках сервера с количеством удачно приобретенных сигналов рендеринга. Это отдало представление о том, какой процент страничек, подвергшихся сканированию, был стопроцентно отрендерен.
Результаты
-
Из наиболее чем 100 тыс. запросов Googlebot, проанализированных на nextjs.org без учета ошибок кода состояния и неиндексируемых страничек, 100% HTML-страниц были стопроцентно отрендерены, включая странички со сложными JS-функциями.
-
Весь контент, загружаемый асинхронно через API-алгоритмы, был удачно проиндексирован, что показывает способность Googlebot обрабатывать динамически загружаемый контент.
-
Next.js, фреймворк на базе React, был стопроцентно отрендерен Googlebot, подтверждая сопоставимость с современными JavaScript-фреймворками.
-
Потоковый контент через RSC также был стопроцентно отрендерен, тем подтвердилось, что потоковая передача не оказывает негативного воздействия на SEO.
-
Гугл пробует показать фактически все HTML-страницы, которые он сканирует, а не только лишь подгруппу страничек с огромным количеством JavaScript.
Миф №2: Гугл обрабатывает странички с JavaScript по-другому, не так, как те, где нет JS
Всераспространенным заблуждением будет то, что Гугл применяет особенные процессы либо требования к страничкам, содержащим JavaScript. Это исследование в сочетании с официальными заявлениями Гугл стопроцентно опровергает этот миф.
Тестирование идеи
Чтоб проверить, вправду ли Гугл по-разному относится к страничкам, содержащим JS, Vercel и MERJ употребляли несколько мотивированных подходов:
-
Тест CSS @import. Они сделали тестовую страничку без JavaScript, но с CSS-файлом, который @imports 2-ой CSS-файл. 2-ой файл загружался и отображался в логах сервера лишь опосля рендеринга первого CSS-файла. Сравнивая это поведение со страничкой с JS, создатели исследования могли проверить, обрабатывает ли рендерер Гугл CSS по-разному с включенным JS и без него.
-
Обработка кода состояния и метатегов. В качестве промежного ПО (то есть программное обеспечение — комплект программ для компьютеров и вычислительных устройств) создатели исследования разработали приложение Next.js для тестирования разных кодов состояния HTTP в Гугл. Анализ был сосредоточен на том, как Гугл обрабатывает странички с разными кодами состояния (200, 304, 3xx, 4xx, 5xx) и странички с метатегами noindex. Это посодействовало осознать, по-разному ли обрабатываются странички, содержащие JavaScript, в этих сценариях.
-
Анализ трудности JavaScript. Сравнили поведение Гугл при рендере страничек с различным уровнем трудности JS на веб-сайте nextjs.org. Сюда вошли странички с наименьшим количеством JS, странички с умеренным уровнем интерактивности и высокодинамичные странички с интенсивным client-side-рендерингом. В исследовании также высчитали и сравнили время меж начальным сканированием и завершенным рендерингом, чтоб осознать, приводил ли наиболее непростой JS к повышению очередей рендеринга либо времени обработки.
Результаты
-
Тест CSS @import подтвердил, что Гугл удачно рендерит странички как с JS, так и без него.
-
Гугл показывает все HTML-страницы со статусом 200 независимо от содержания JS. Странички со статусом 304 показываются с внедрением содержимого уникальной странички со статусом 200. Странички с иными ошибками 3xx, 4xx и 5xx не показываются.
-
Странички с метатегами noindex в начальном HTML-ответе не показывались независимо от содержания JS. Удаление тегов noindex на стороне клиента неэффективно для SEO-целей; если страничка содержит тег noindex в начальном HTML-ответе, она не будет отрисована, а JavaScript, удаляющий тег, не будет выполнен.
-
Создатели исследования не узрели значимой различия в удачливости рендеринга Гугл страничек с различным уровнем трудности JS. В масштабах nextjs.org также не нашли корреляции меж сложностью JavaScript и задержкой рендеринга. Но наиболее непростой JS на еще наиболее большом веб-сайте может воздействовать на эффективность сканирования.
Миф №3: Очередь рендеринга и время весьма важны исходя из убеждений SEO
Почти все SEO-специалисты считают, что странички с огромным количеством JavaScript существенно задерживаются в индексации из-за очереди рендеринга. Наше исследование дает наиболее точное представление о этом процессе.
Тестирование идеи
Чтоб узнать воздействие очередности и сроков рендеринга на SEO, проанализировали:
-
задержки рендеринга. Создатели исследования исследовали разницу во времени меж начальным сканированием странички Гугл и окончанием ее рендеринга, используя данные наиболее 37 тыс. пар на веб-сайте nextjs.org;
-
типы URL. Проанализировали время рендеринга для URL со строчками запросов и без их, также для разных разделов nextjs.org (к примеру, /docs, /learn, /showcase);
-
частоту запросов. Проверили, как нередко Гугл пересматривает странички и есть ли закономерности в частоте рендеринга для различных типов контента.
Результаты
Распределение задержки рендеринга смотрится последующим образом:
-
50-й процентиль (медиана): 10 секунд
-
75-й процентиль: 26 секунд
-
90-й процентиль: ~3 часа
-
95-й процентиль: ~6 часов
-
99-й процентиль: ~18 часов
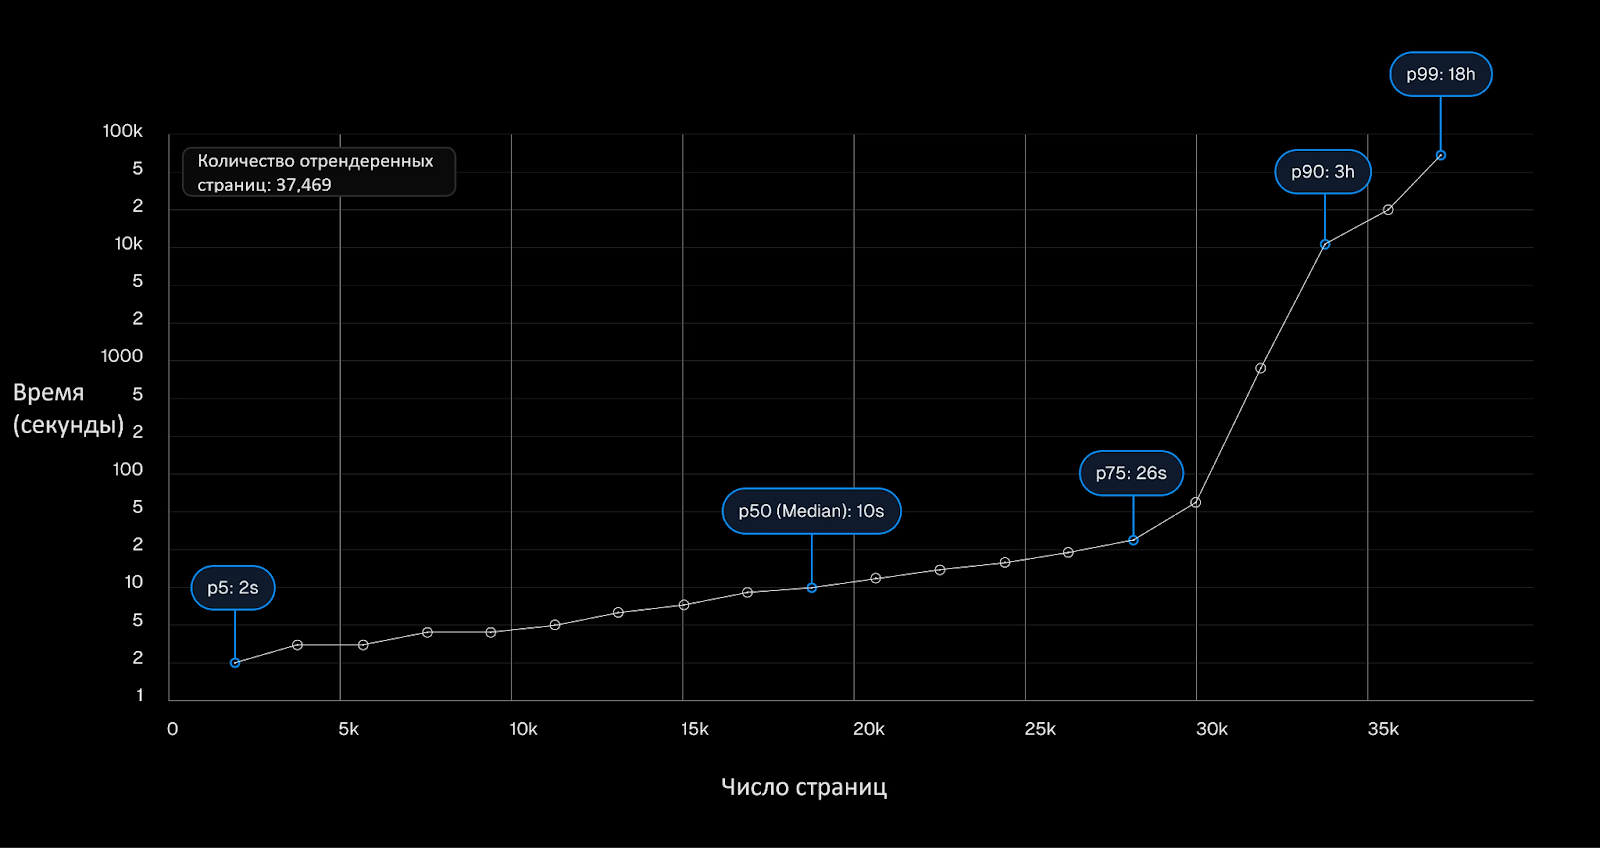
Четкое распределение задержки рендеринга на базе 37 тыс. результатов
Умопомрачительно, но 25-й процентиль страничек отображался в течение 4 секунд опосля начального сканирования, что опровергает представление о длинноватой «очереди».
Хотя на неких страничках наблюдались значимые задержки (до ~18 часов в 99-м процентиле), такие случаи были быстрее исключением, чем закономерностью.
Создатели исследования также увидели достойные внимания закономерности, связанные с тем, как стремительно Гугл показывает URL со строчками запросов (?param=xyz):
|
Тип URL |
50-й процентиль |
75-й процентиль |
90-й процентиль |
|
Все URL-адреса |
10 секунд |
26 секунд |
~3 часа |
|
URL-адреса без строчки запроса |
10 секунд |
22 секунды |
~2,5 часа |
|
URL со строчкой запроса |
13 секунд |
31 минутка |
~8,5 часа |
❗️ Приобретенные данные свидетельствуют о том, что Гугл по-разному относится к URL, если они содержат строчки запросов, не действующие на содержимое.
К примеру, на веб-сайте nextjs.org странички с параметрами ?ref= имели наиболее долгие задержки рендеринга, в особенности при больших процентилях.
Не считая того, Vercel и MERJ увидели, что нередко обновляемые разделы, такие как /docs, имели наиболее куцее медианное время рендеринга по сопоставлению с наиболее статичными разделами.
К примеру, страничка /showcase, невзирая на то, что на нее нередко ссылаются, показала большее время рендеринга. Это гласит о том, что Гугл может замедлить повторный рендеринг для страничек, которые не претерпевают значимых конфигураций.
Миф №4: Веб-сайты, перегруженные JavaScript, медлительнее обнаруживаются Гугл
В SEO-сообществе существует устойчивое мировоззрение, что веб-сайты с огромным количеством JavaScript, в особенности те, которые употребляют клиентский рендеринг (CSR), к примеру одностраничные приложения (SPA), мучаются от наиболее неспешного обнаружения страничек Гугл. Благодаря проведенному исследованию возникла новенькая информация.
Тестирование идеи
Чтоб изучить воздействие JavaScript на обнаружение страничек, Vercel и MERJ:
-
проанализировали обнаружение ссылок в разных сценариях рендеринга. Ассоциировали скорость обнаружения и сканирования Гугл ссылок на страничках с серверным, статическим и client-side-рендерингом на веб-сайте nextjs.org;
-
протестировали нерендерируемые перегрузки на JavaScript. На страничку /showcase веб-сайта nextjs.org был добавлен объект JSON, схожий на компонент React Server Component (RSC), содержащий ссылки на новейшие, ранее не обнаруженные странички. Так проверили, может ли Гугл найти ссылки в данных JavaScript, которые не были отображены;
-
сравнили время обнаружения. Создатели выслеживали, как стремительно Гугл обнаруживает и сканирует новейшие странички, связанные разными методами: обычные HTML-ссылки, ссылки в клиентском рендеринге контента и ссылки в нерендерируемых JavaScript-файлах.
Результаты
-
Гугл удачно нашел и проиндексировал ссылки на стопроцентно отрендеренных страничках независимо от способа рендеринга.
-
Гугл может обнаруживать ссылки в неотрендеренных JavaScript-данных на страничке, таковых как те, что находятся в компонентах сервера React либо подобных структурах.
-
И в исходном, и в отрендеренном HTML Гугл обрабатывает контент, идентифицируя строчки, которые смотрятся как URL, используя текущий хост и порт в качестве базы для относительных URL.
Гугл не нашел закодированный URL, другими словами https%3A%2F%2Fwebsite.com, что гласит о том, что его парсинг ссылок весьма серьезный.
-
Источник и формат ссылки (к примеру, в теге < a > либо интегрированный в JSON-данные) не воздействовали на то, как Гугл приоритизировал сканирование. Ценность сканирования оставался неизменным независимо от того, был ли URL найден поначалу либо опосля рендеринга.
-
Хотя Гугл удачно обнаруживает ссылки на CSR-страницах, эти странички всё же нужно поначалу отрендерить. Странички, отрендеренные на сервере, либо отчасти за ранее отрендеренные странички имеют маленькое преимущество в незамедлительном обнаружении ссылок.
-
Гугл по-разному относится к обнаружению ссылок и оценке их ценности. Оценка ценности ссылки для архитектуры веб-сайта и приоритизации сканирования происходит опосля полного рендеринга странички.
-
Наличие освеженной sitemap.xml существенно уменьшает, если не избавляет, различия во времени обнаружения меж разными паттернами рендеринга.
Общие выводы и советы
Иследование развенчало несколько всераспространенных легенд о том, как Гугл относится к веб-сайтам, перегруженным JavaScript. Вот главные выводы и советы к предстоящим действиям.
Выводы
-
Гугл может отлично обрабатывать и регистрировать JavaScript-контент, включая сложные SPA, динамически загружаемый и потоковый контент.
-
Нет принципной различия в том, как Гугл обрабатывает странички, содержащие JavaScript, по сопоставлению со статическими HTML-страницами. Все странички рендерятся.
-
Хотя очередь рендеринга существует, ее воздействие наименее существенно, чем числилось ранее. Большая часть страничек обрабатываются в течение нескольких минут, а не дней либо недель.
-
Веб-сайты с внедрением JavaScript, включая SPA, не мучаются от способностей Гугл по обнаружению страничек.
-
Время прибавления определенных частей (к примеру, тегов noindex) на страничку имеет решающее значение, так как Гугл может не обрабатывать client-side-изменения.
-
Гугл различает обнаружение ссылок и оценку их ценности. Крайняя происходит опосля полностраничного рендеринга.
-
Процесс рендеринга Гугл не является строго приоритетным. Такие причины, как свежесть контента и частота обновлений, влияют на расстановку ценностей больше, чем сложность JavaScript.
❗️ Еще более про причины ранжирования Гугл – в нашем переводе нашумевшей книжки Гугл Ranking Factors от Search Engine Journal. Там собраны самые крайние данные по тому, что является фактором ранжирования, а что нет.
Чтоб получить книжку, перейдите в @TopvisorBot. Нажмите на раздел «Меню» в левом нижнем углу и изберите «Открыть библиотеку».
-
Хотя Гугл может отлично рендерить странички с огромным количеством JS, этот процесс просит больше ресурсов по сопоставлению со статическим HTML как вам, так и для Гугл.
Для больших веб-сайтов (10 тыс.+ неповторимых и нередко меняющихся страничек) это может воздействовать на бюджет сканирования веб-сайта. Если улучшить производительность приложения и свести к минимуму ненадобный JS, это поможет убыстрить процесс рендеринга, повысить эффективность сканирования и, может быть, дозволит отрендерить, проиндексировать и просканировать больше ваших страничек.
Советы
-
Используйте JavaScript. Свободно используйте JavaScript-фреймворки для увеличения удобства юзеров и разрабов, но при всем этом уделяйте главное внимание производительности и руководствуйтесь наилучшими советами Гугл по отложенной загрузке.
-
Устраняйте ошибки. В приложениях React используйте Error boundaries, чтоб предупредить полные сбои рендеринга из-за ошибок отдельных компонент.
-
Направьте внимание на принципиальные SEO-элементы. Используйте рендеринг на стороне сервера либо статическую генерацию для важных SEO-тегов и релевантного контента, чтоб они непременно присутствовали в начальном HTML-ответе.
-
Управляйте ресурсами. Удостоверьтесь, что критичные ресурсы для рендеринга (API, файлы JavaScript, файлы CSS) не заблокированы robots.txt.
-
Обновляйте контент. Если контент нуждается в резвой переиндексации, удостоверьтесь, что конфигурации отражаются в HTML, отрендеренном на сервере, а не только лишь в JavaScript на стороне клиента. Разглядите такие стратегии, как Incremental Static Regeneration, чтоб соблюсти баланс меж свежестью контента, SEO и производительностью.
-
Делайте грамотную внутреннюю перелинковку и структуру URL. Сделайте четкую, логичную структуру внутренней перелинковки. Реализуйте принципиальные навигационные ссылки в виде реальных HTML-анкорных тегов (< a href="…" >), а не навигации на базе JavaScript. Таковой подход помогает юзерам в навигации и сканировании поисковыми машинами, также потенциально понижает задержки при рендеринге.
-
Используйте и часто обновляйте карты веб-сайта. Для больших веб-сайтов либо веб-сайтов с частыми обновлениями используйте тег < lastmod > в XML-карте веб-сайта, чтоб направлять процессы сканирования и индексирования Гугл. Не запамятовывайте обновлять < lastmod > лишь при больших обновлениях контента.
-
Используйте инструмент проверки URL Гугл Search Console. Он поможет проверить, как Googlebot лицезреет ваши странички. Смотрите за статистикой сканирования.
Основное
Как мы уже узнали, есть некие различия меж стратегиями рендеринга, дозволяющие по-разному воплотить способности Гугл. Они собраны в таблице:
|
Изюминка / Вид рендеринга |
Статическая генерация веб-сайтов (SSG) |
Инкрементная статическая регенерация (ISR) |
Server-Side-рендеринг (SSR) |
Client-Side-рендеринг (SSR) |
|
Эффективность сканирования: как стремительно и отлично Гугл получает доступ к интернет-страницам, выводит их на экран и извлекает информацию |
Непревзойденно |
Непревзойденно |
Весьма отлично |
Плохо |
|
Обнаружение: процесс поиска новейших URL-адресов для сканирования* |
Непревзойденно |
Непревзойденно |
Непревзойденно |
Средне |
|
Полнота рендеринга (ошибки, сбои и т. д.): как буквально и много Гугл может загрузить и обработать ваши интернет-страницы без ошибок |
Надёжно |
Надёжно |
Надёжно |
Вероятен сбой** |
|
Время рендеринга: сколько времени требуется Гугл для полного рендеринга и обработки веб-страниц |
Непревзойденно |
Непревзойденно |
Непревзойденно |
Плохо |
|
Оценка структуры ссылок: как Гугл оценивает ссылки, чтоб осознать архитектуру веб-сайта и значимость страничек |
Опосля рендеринга |
Опосля рендеринга |
Опосля рендеринга |
Опосля рендеринга ссылки могут отсутствовать в случае сбоя рендеринга |
|
Индексирование: процесс, в процессе которого Гугл сохраняет и упорядочивает содержимое вашего веб-сайта |
Надёжно |
Надёжно |
Надёжно |
При неудачном рендеринге индексация может провалиться |
* Наличие обновлённого sitemap.xml существенно уменьшает, если не избавляет, разницу во времени обнаружения меж разными шаблонами рендеринга.
** Как показало исследование, рендеринг в Гугл обычно не дает сбоев. А когда это происходит, это нередко соединено с блокировкой ресурсов в robots.txt либо специфичными вариантами.
Естественно, есть маленькие различия, но Гугл стремительно увидит и проиндексирует веб-сайт независимо от стратегии рендеринга. Сосредоточьтесь на разработке производительных веб-приложений, которые приносят пользу юзерам, а не волнуйтесь о особых решениях для процесса рендеринга Гугл.
В конце концов, скорость странички все равно является фактором ранжирования, так как Гугл оценивает производительность веб-сайта на базе характеристик Гугл Core Web Vitals.
Проверить скорость странички и остальные CWV можно в Анализе веб-сайта от Топвизора.
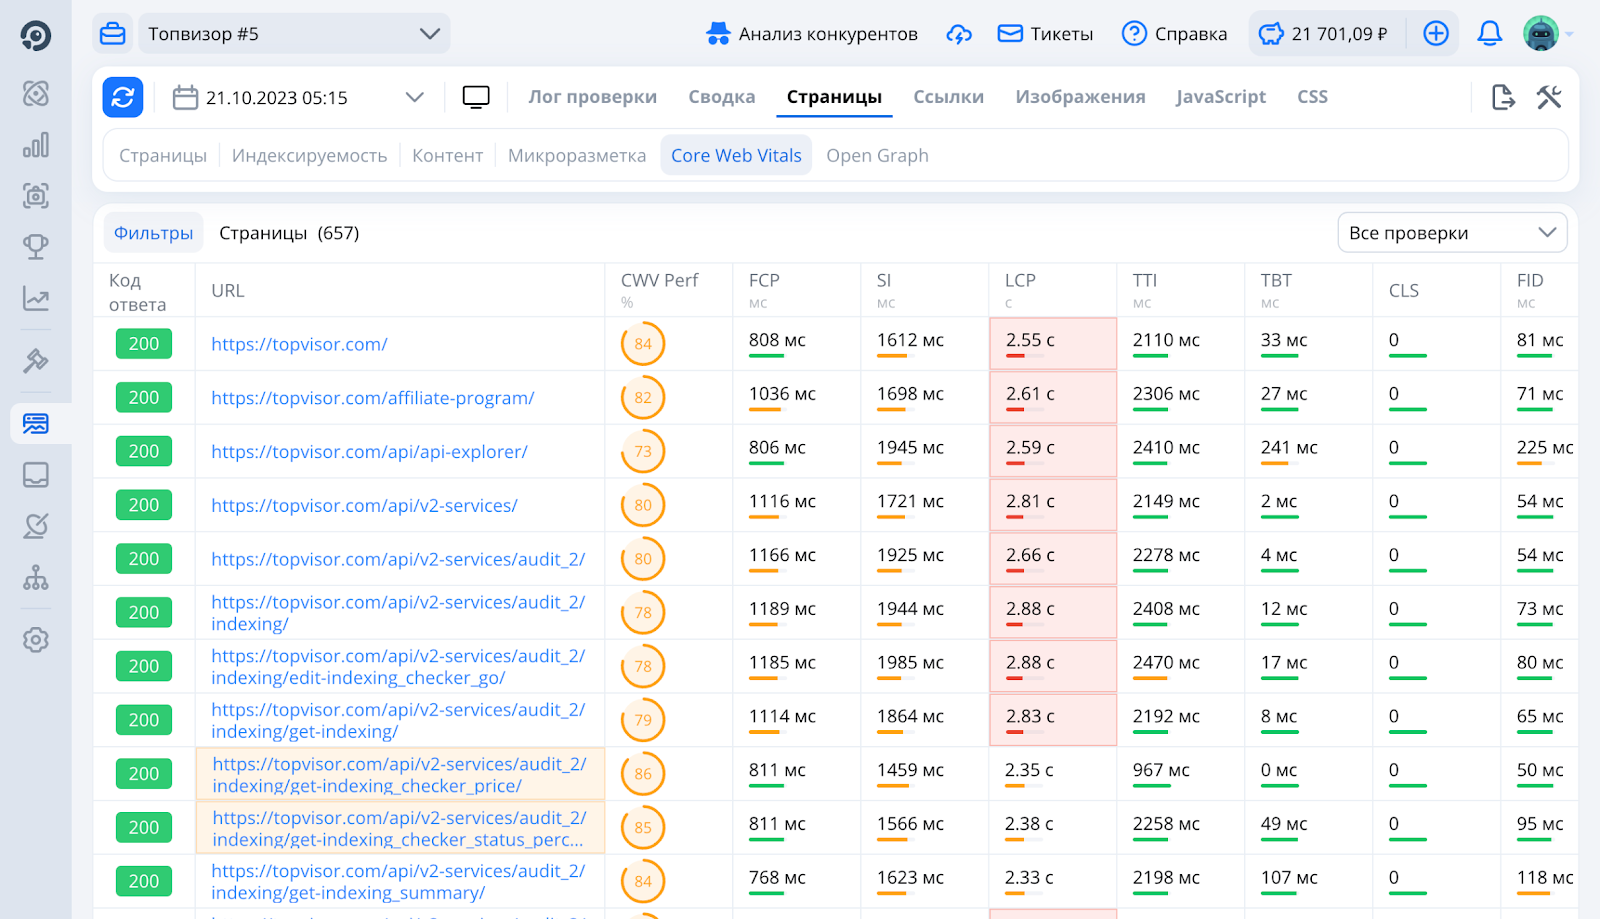
Сервис покажет быстродействие веб-сайта по главным показателям: FCP, SI, LCP, TTI, TBT, CLS, FID, TTFB. Также общий показатель Performance странички по данным PageSpeed Insights.
Не считая того, скорость странички впрямую влияет на удобство работы с веб-сайтом. По данным Deloitte (веб-сайт недоступен в Рф), любые 100 миллисекунд сэкономленного времени загрузки соответствуют повышению конверсии веб-сайта на 8%. Наименьшее количество юзеров, покидающих страничку, значит, что Гугл разглядывает её как наиболее релевантную. Миллисекунды влияют на производительность, а она критически принципиальна.