

Автоматизация SEO через LLM: архитектура, стек и настоящие числа
Когда семантическое ядро разрастается до сотен тыщ запросов, увеличивать темп вручную становится недешево и трудно. Логичное решение – не нанимать десяток доп профессионалов, а заавтоматизировать процессы.
Мы приложили это к SEO – так возник пайплайн автоматизации с LLM. Итог – экономия в 3–6 раз и убыстрение в 10–15. Разбираем технические подробности и делимся впечатлениями.
Почему совершенно решили заавтоматизировать
Мы делали задачку для клиента: за полгода собрать семантику для 500 000 кластеров. Требовалось выстроить структуру, прописать H1 и анкоры, типизировать странички.
Команда из 6 человек за три месяца обработала лишь 10% запланированного размера. Рентабельность проекта свалилась до минус 60%, все перерабатывали, свойство мучалось. Масштабирование традиционным методом означало бы найм еще 12–15 человек – с теми же неуввязками координации и контроля свойства.
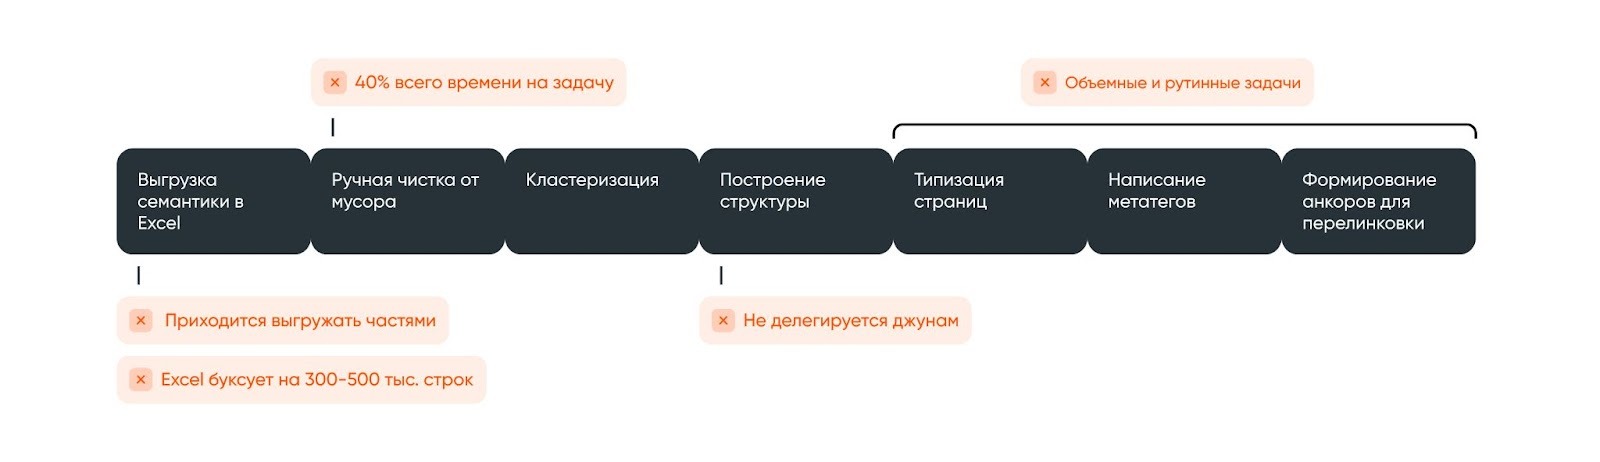
Традиционный SEO-процесс для большого проекта включает семь шагов:
-
Выгрузка семантики из сервисов в Excel.
-
Ручная очистка от мусора.
-
Кластеризация.
-
Построение структуры.
-
Типизация страничек.
-
Написание метатегов.
-
Формирование анкоров для перелинковки.
Любой шаг упирается в технические либо людские ограничения.
Keys.so по дефлоту не дает всю семантику сходу по большим проектам – приходится выгружать частями. Excel останавливается на миллионе строк, а буксовать начинает уже на 300–500 тыщах. Очистка семантического ядра съедает до 40% времени команды. Построение структуры просит опыта и внимания – делегировать джунам не получится. Типизация страничек, теги и анкоры – рутина, но большая.
Что сделали: трехуровневая архитектура
Выстроили систему, где база данных хранит миллионы запросов, Python-парсер управляет действием, а LLM обрабатывает данные. Рассказываем подробнее.
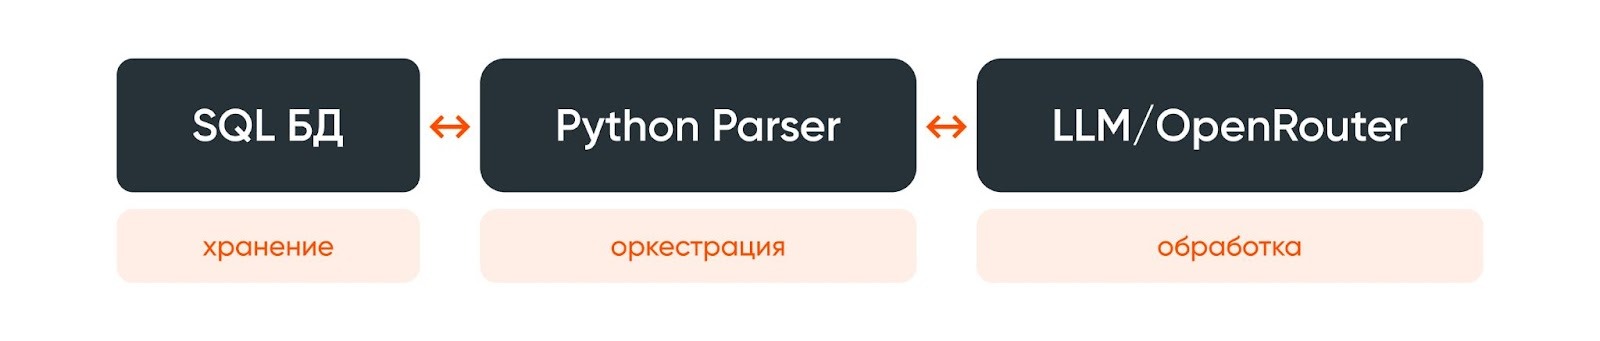
Уровень 1: SQL БД – хранилище и источник данных
База данных подменяет Excel. Она обеспечивает работу с миллионами строк без пробуксовок, воспринимает данные по API из Keys.so и JustMagic, сама мэтчит ключи (резвее и надежнее) и дает данные порциями для обработки.
В базе лежит все: сам запрос, частотность, позиции и URL соперников из выдачи, группы, номера кластеров, типы страничек, заглавия.
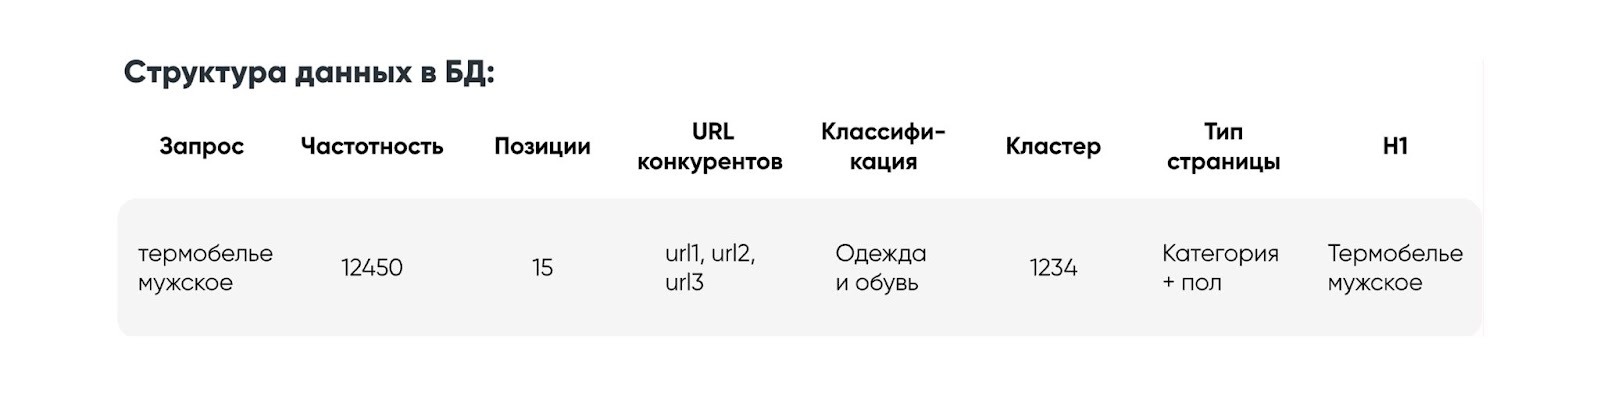
Уровень 2: Python Parser – оркестратор процесса
Парсер берет данные из базы, разбивает на фрагменты по 200–300 строк (это предел LLM), посылает по API к нейросети, соединяет воединыжды результаты в общий перечень.
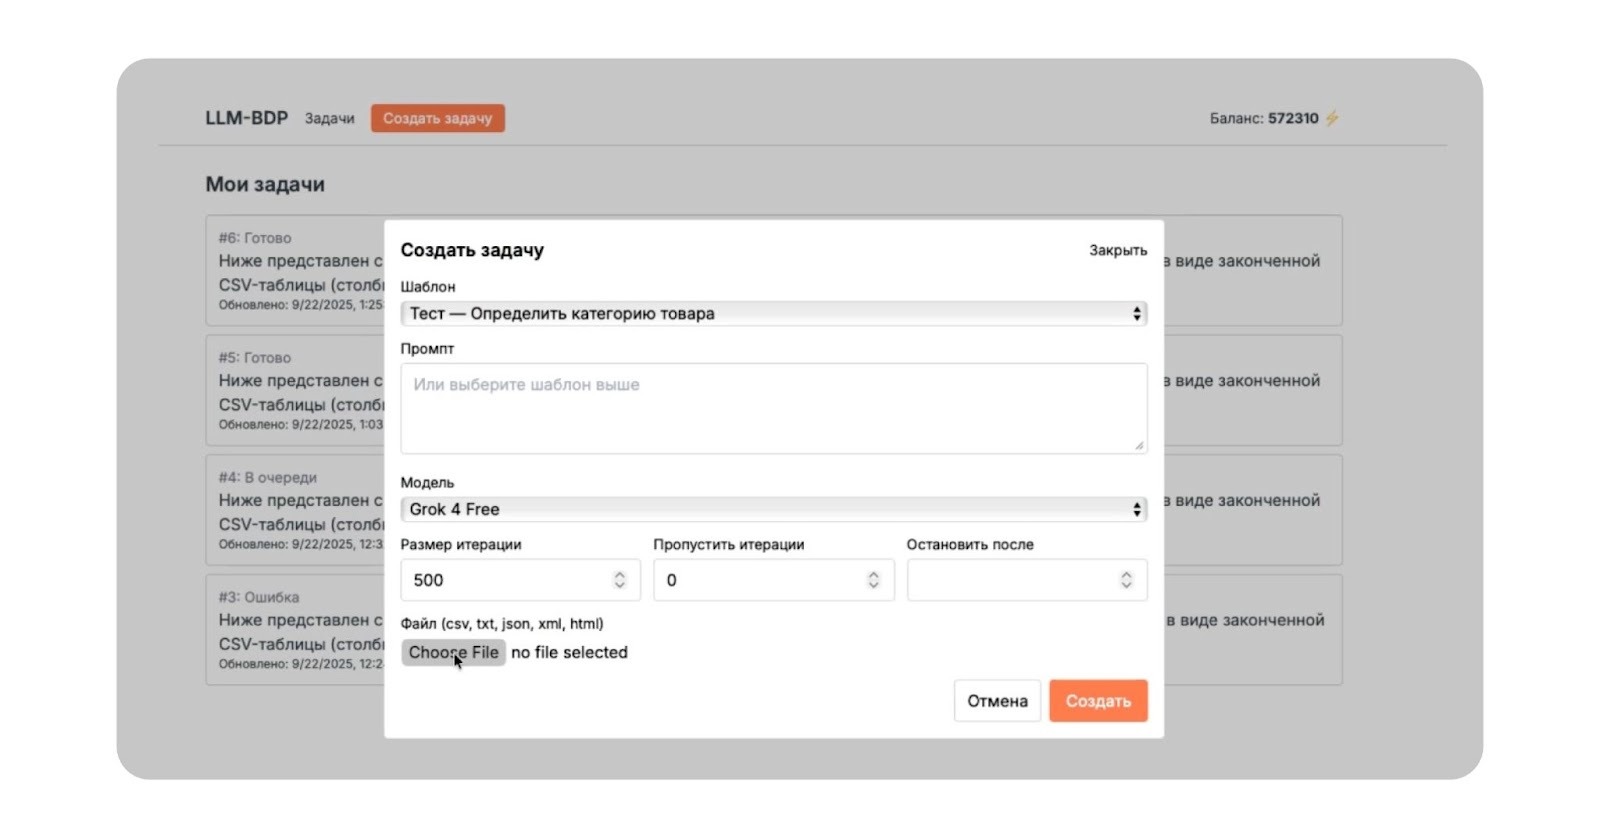
Интерфейс парсера дозволяет избрать шаблон задачки (очистка семантики, генерация H1, построение структуры, формирование анкоров), отредактировать промпт, выбирать из сотен доступных моделей, задать размер итерации и количество параллельных запусков.
Уровень 3: LLM через OpenRouter – обработчик данных
В OpenRouter можно переключаться меж 300+ моделями, мониторить популярность и тренды, работать с единой биллинговой системой.
По данным платформы, для SEO и маркетинга почаще употребляют Claude 3.7 Sonnet, GPT-4o-mini, Gemini 2.0 Flash и Gemini 2.0 Flash Lite. Но мы удостоверились: модели демонстрируют разную точность на определенных шагах.
По нашему опыту, для очистки семантики оптимальна Gemini Flash 2, для построения структуры – DeepSeek V3.1, для генерации заголовков – Gemini 2.5 Flash.
Пайплайн: три блока обработки
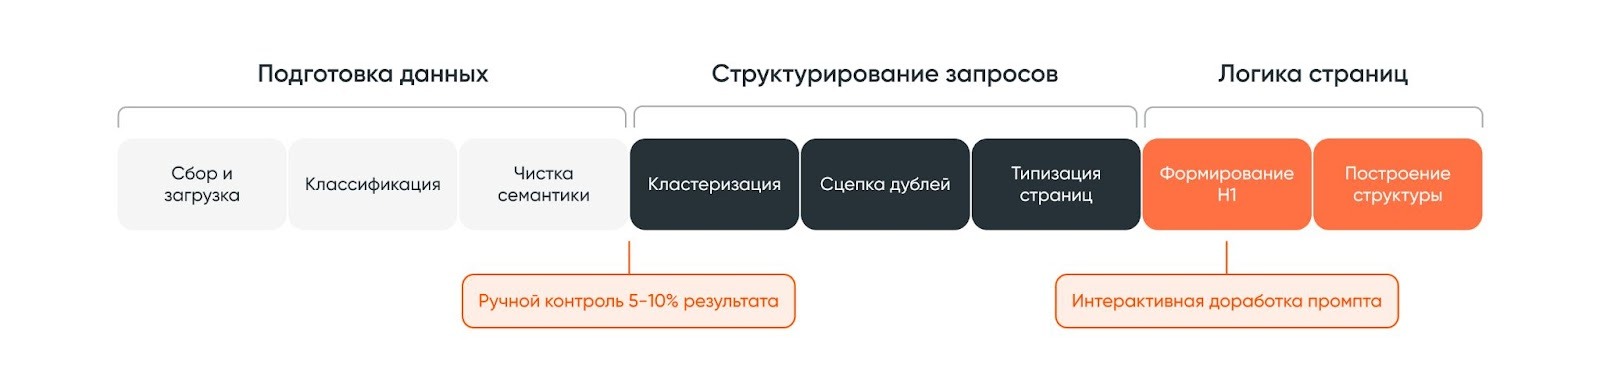
1. Подготовка данных
Сбор и загрузка
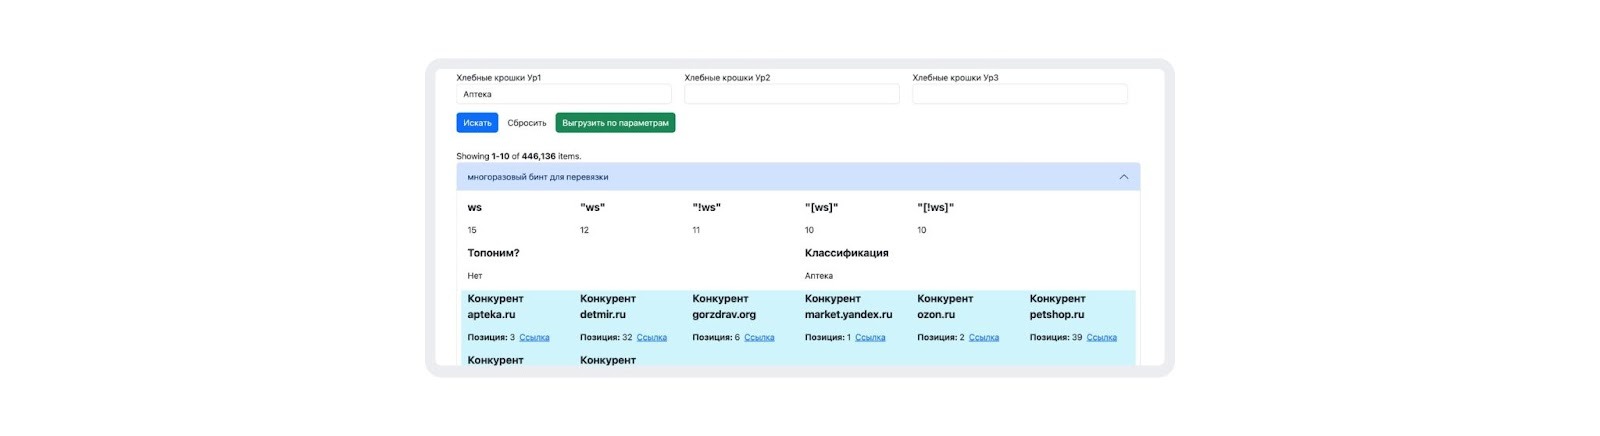
Запускаем API-парсинг по фрагментам – результаты сходу соединяются воединыжды в SQL-базе.
Систематизация
Тут определяем категорию всякого запроса. К примеру, «штаны мужские» относятся к одежке и обуви, «палатка 4 местная» – к спорту и отдыху, «кольцо с сапфиром» – к ювелирным украшениям. Это дозволяет на старте отсечь нерелевантные группы и сосредоточиться на приоритетных либо сезонных.
Подойдет модель Gemini Flash 2.
|
Пример промпта «Обусловь категорию из перечня доступных, возврати лишь заглавие без пояснений». |
Очистка семантики
Задачка – отделить коммерческие запросы от мусора. К нему относятся навигационные, информационные и нерелевантные запросы.
Для наибольшего свойства (но со сниженной скоростью) подойдет DeepSeek V3. Для баланса «стремительно/отменно» – Gemini Flash 2.
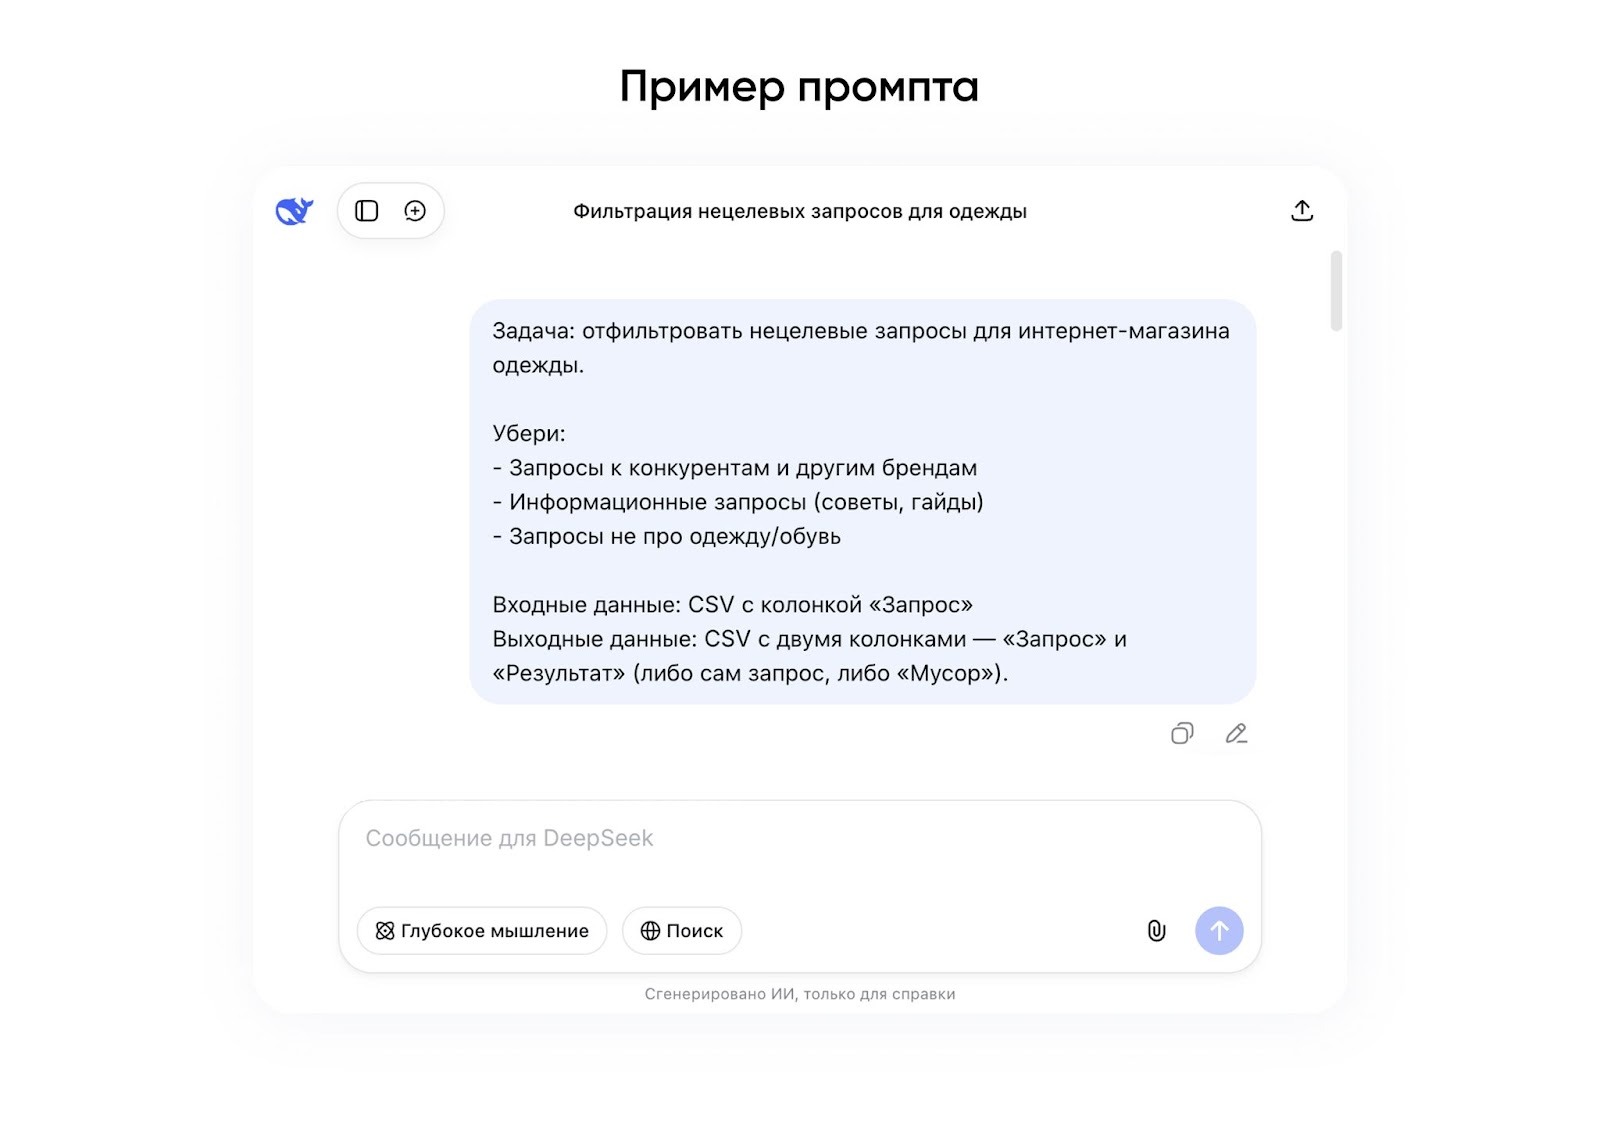
Принципиально: на этом шаге делаем «сверку с реальностью»: контролируем, что LLM не растеряла принципиальное. Это не на сто процентов ручная работа, а выборочный контроль 5–10% результата. Его стоит поручить миддлу либо сеньору.
2. Структурирование запросов
Кластеризация
Сгруппировать запросы по интенту – задачка, которая пока не под силу LLM. Потому берем испытанные инструменты: Key Collector, Rush Analytics, Топвизор, собственные методы.
Сцепка дублей
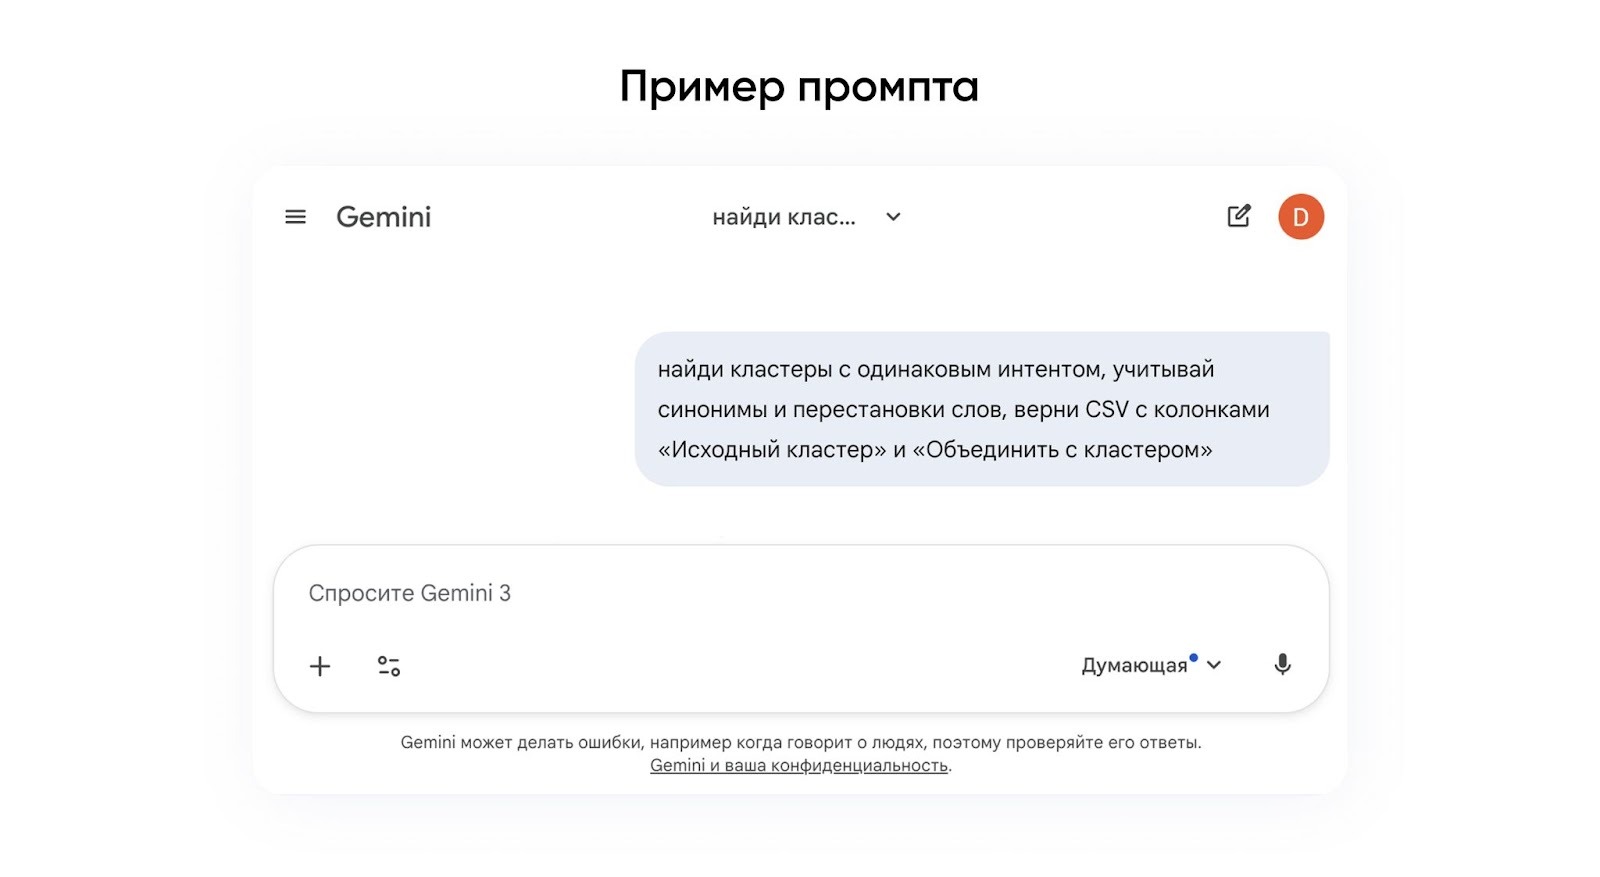
LLM находит и соединяет воединыжды кластеры, которые схожи по смыслу. С различным порядком слов как в «штаны мужские» и «мужские штаны», «куртка зимняя женская» и «зимняя женская куртка», либо с однокоренными, как в «кольцо с сапфиром» и «сапфировое кольцо».
Тут хороша модель Gemini 2.5 Flash – она стремительная, дает минимум утрат.
Типизация страничек
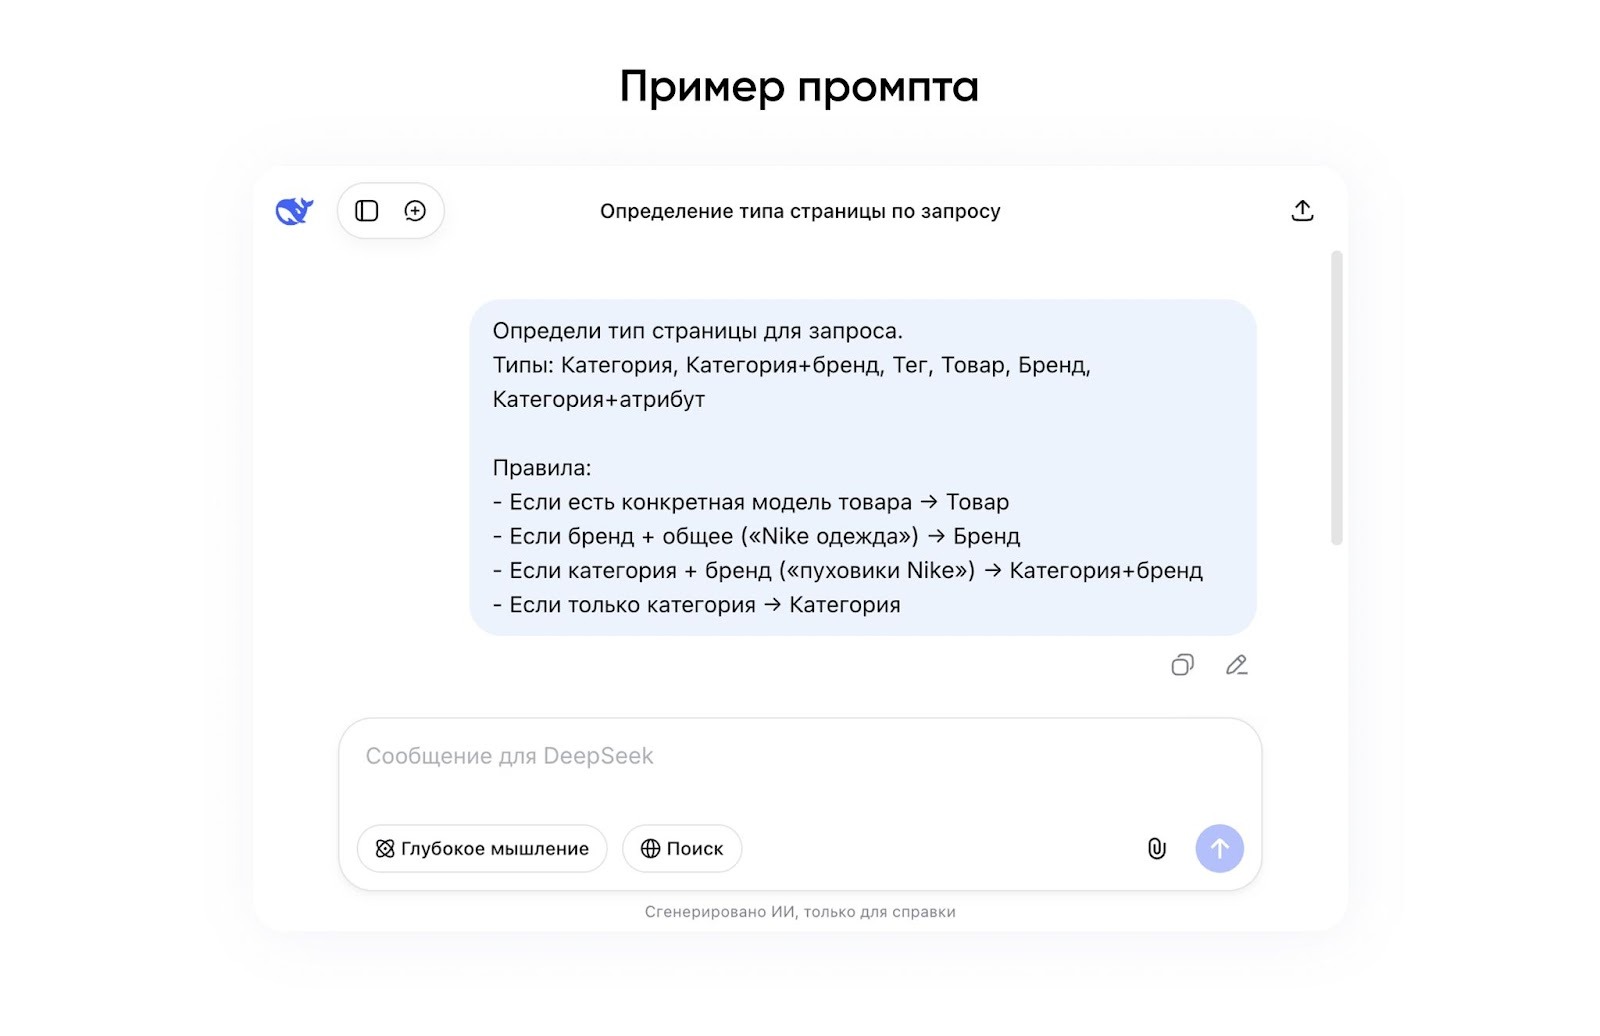
Сейчас необходимо найти тип странички для всякого кластера – от этого зависят шаблон, структура URL и стратегия продвижения.
Используем DeepSeek V3.1, ведь здесь принципиальна точность.
3. Логика страничек
Формирование H1
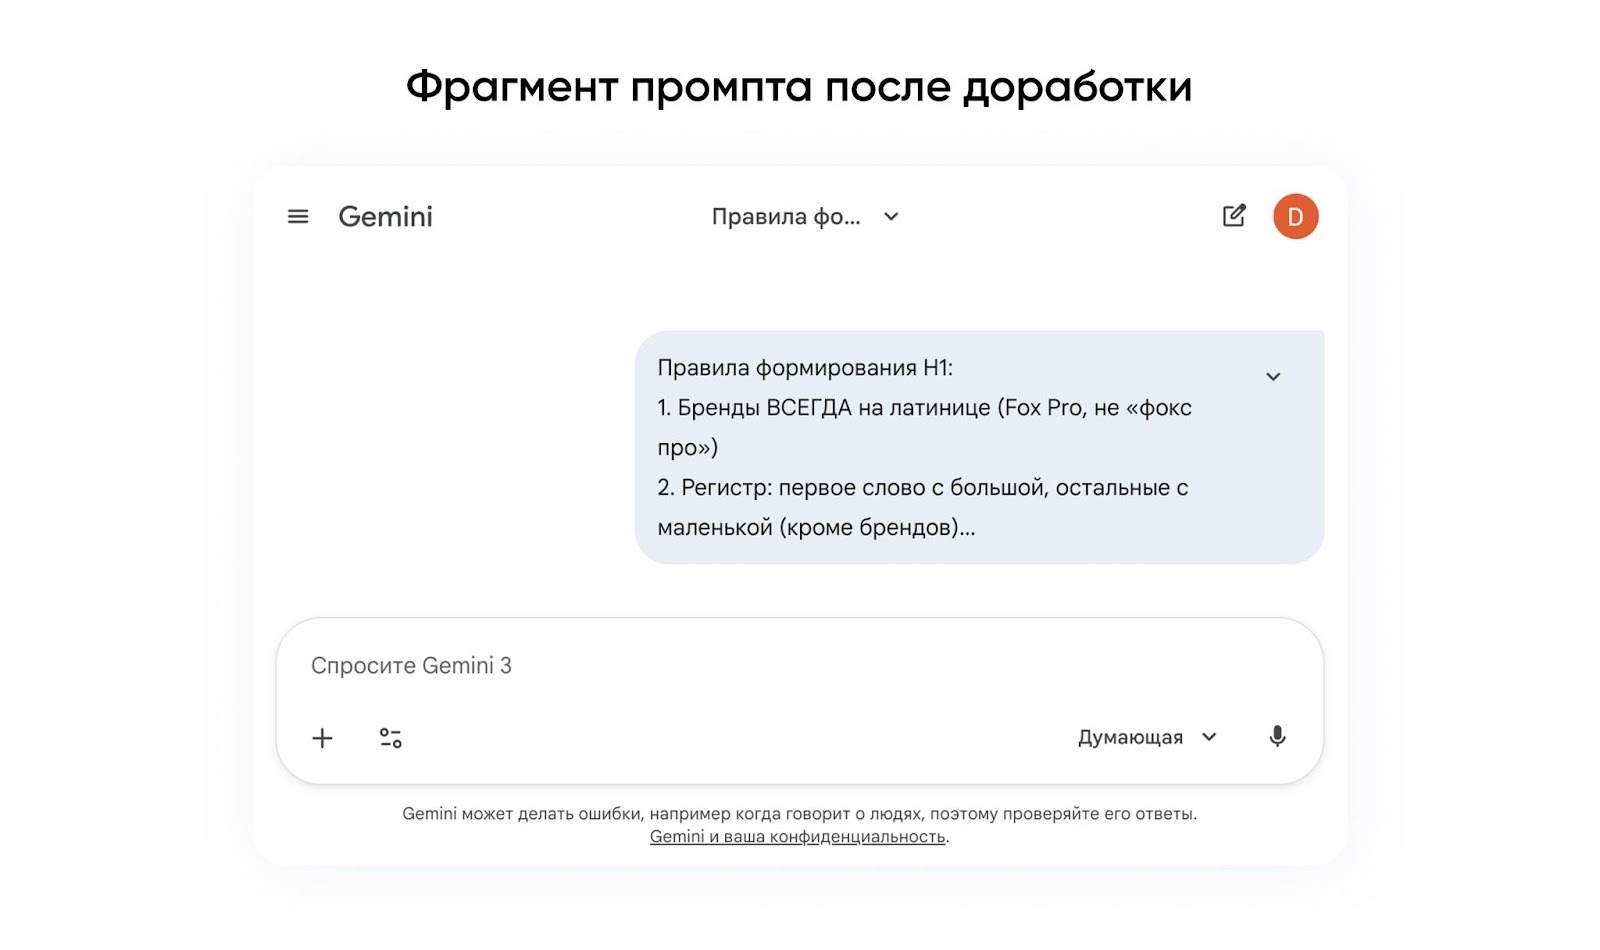
Написать заголовок для каждой странички – задачка, где нужна естественность. Для этого принципиально учесть ряд аспектов: язык написания бренда, регистр и порядок слов, число (единственное либо множественное) как в запросе.
Модель Gemini 2.5 Flash на этом шаге стремительно выдает применимое свойство. Но может потребоваться итеративная доработка:
прогнали модель → сравнили итог с ручным образцом → зафиксировали типовые ошибки → уточнили правила в промпте.
Повторяем, пока не останемся довольны уровнем.
Построение структуры
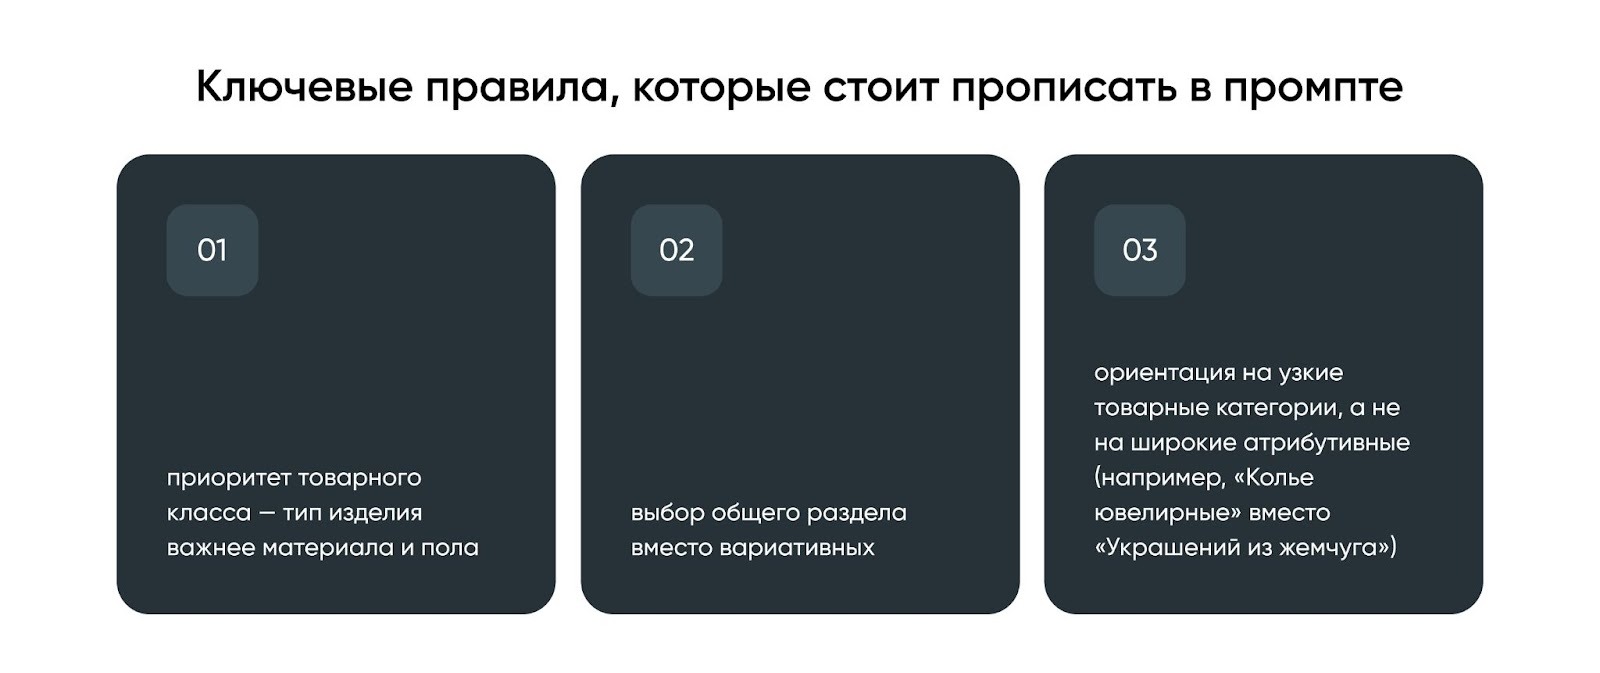
Теговые странички необходимо привязать к категориям и выстроить иерархию – здесь логика важнее скорости.
Пример: тег «Колье из жемчуга» можно выслать к «украшениям из жемчуга» либо к «ювелирным колье». Нам нужна 2-ая категория: товарный класс важнее материала.
DeepSeek V3.1 – самая четкая модель для проработки структуры.
Что получили: числа и сопоставление
Проект, с которым мы работали – топ-10 e-commerce в Рф. Брали категорию «одежка и обувь». За три месяца с автоматизацией обработали 450 000 кластеров (без ИИ было бы 50 000). Сделали 690 000 новейших страничек, проработали 19 000 категорий. Общий размер семантики – 6 млн запросов.
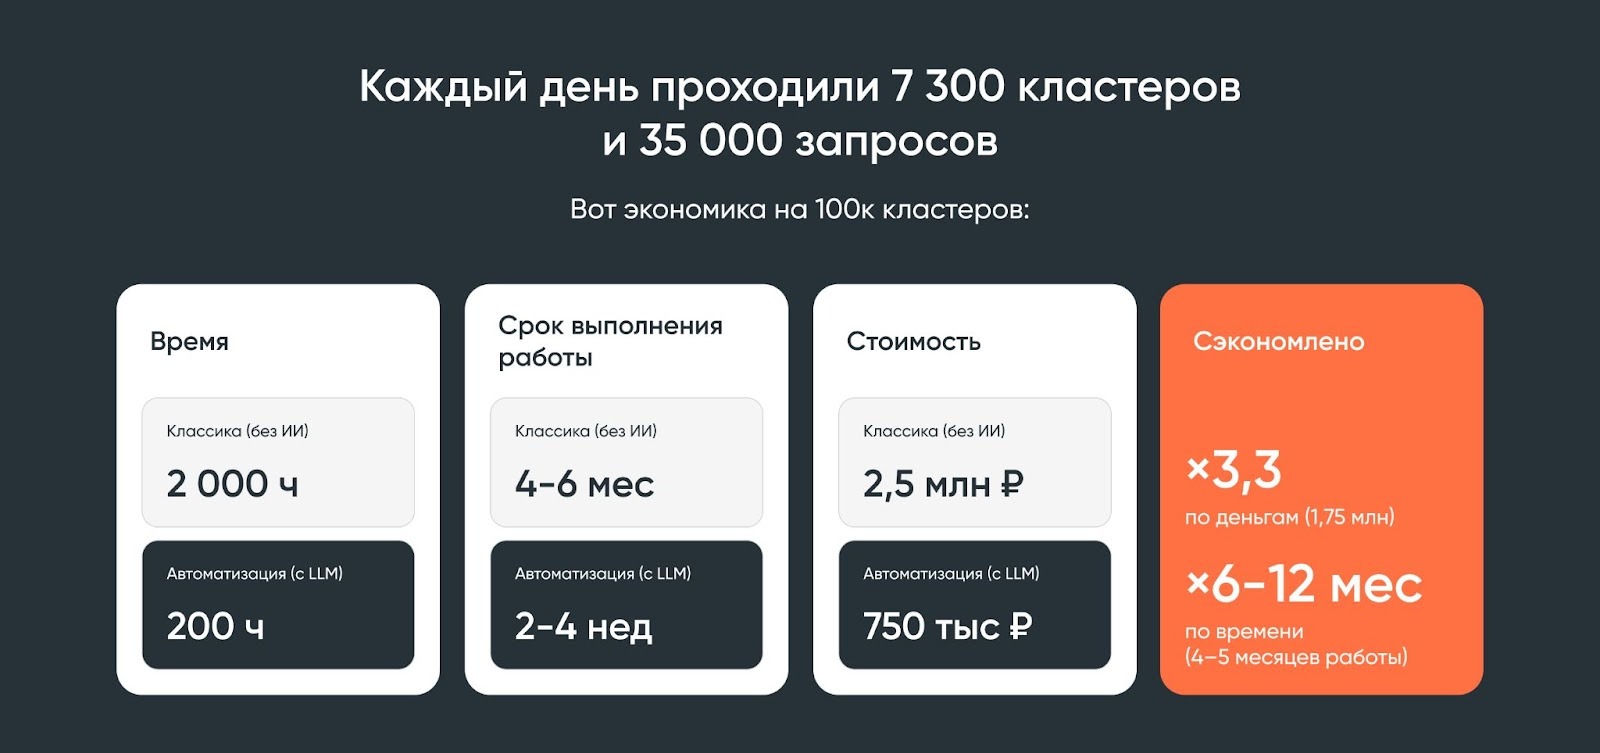
Принципиально: автоматизация прибыльна не постоянно.
Настройка пайплайна съест около 100 ч и 200 000 ₽. Вложения начинают окупаться от 1000, а кратная экономия выходит лишь от 10 000 кластеров. На масштабах 100 000+ вручную совершенно нереально уложиться в разумный срок – тут совершенно точно необходимо заавтоматизировать.
Ограничения автоматизации
Внедрение LLM в SEO не отменяет работу профессионалов. Их задачка – управлять автоматизацией и врубаться на шагах, где без ручного контроля и корректировок масштабирование не имеет смысла.
Вот почему без работы руками не обойтись.
LLM по дефлоту не погружены в бизнес
Они не учитывают колебания спроса, фактический ассортимент и ограничения брендов. Модели могут сгенерировать структуру под отсутствующие продукты либо «мимо сезона». Потому непременно – проверка 5–10% результата и корректировка промптов под нишу.
API могут падать
В тестах GPT-4o демонстрировал до 32% сбоев API, Qwen3 – порядка 20% утрат данных. Потому принципиально применять устойчивые модели (Gemini, Claude, DeepSeek), иметь под рукою запасные варианты и логировать все запросы.
Кластеризация – слабенькое пространство LLM
Искусственный ум пока неустойчиво совладевает с кластеризацией запросов по интенту. Потому необходимы испытанные сервисы (Topvisor, Rush Analytics, Key Collector) и грамотные спецы, которые сумеют с ними работать.
Модели не всепригодны
Ошибка – применять одну LLM для всего. Этапы требуют различных ценностей: для очистки семантики это скорость и стоимость, для структуры и типизации – наибольшая точность, для H1 – баланс свойства и времени. Задачка спеца – подобрать модель под задачку.
Промпты тоже не всепригодны
Логика группировки зависит от ниши. Для ювелирных веб-сайтов «кольцо с сапфиром» – это категория «Кольца». В одежке цветовые признаки работают как теги. Решает поэтапное тестирование и доработка промптов.
|
Основной принцип автоматизации: не подменять людей, а отдать им инструменты для работы с нечеловеческими размерами. |
Оригинал статьи на SEOnews