

Веб-сайт живой, а трафика из Гугл нет: один неочевидный киллер индексации
Представьте, что у вашего веб-сайта резко свалился поисковый трафик из Гугл. Сперва вы входите с проверкой на веб-сайт – там все летает, странички грузятся одномоментно. Но вы открываете Гугл Search Console и видите, как странички одна за иной исчезают из индекса. Поначалу второстепенные, позже основная. И никто не соображает, в чем дело, веб-сайт же работает совершенно.
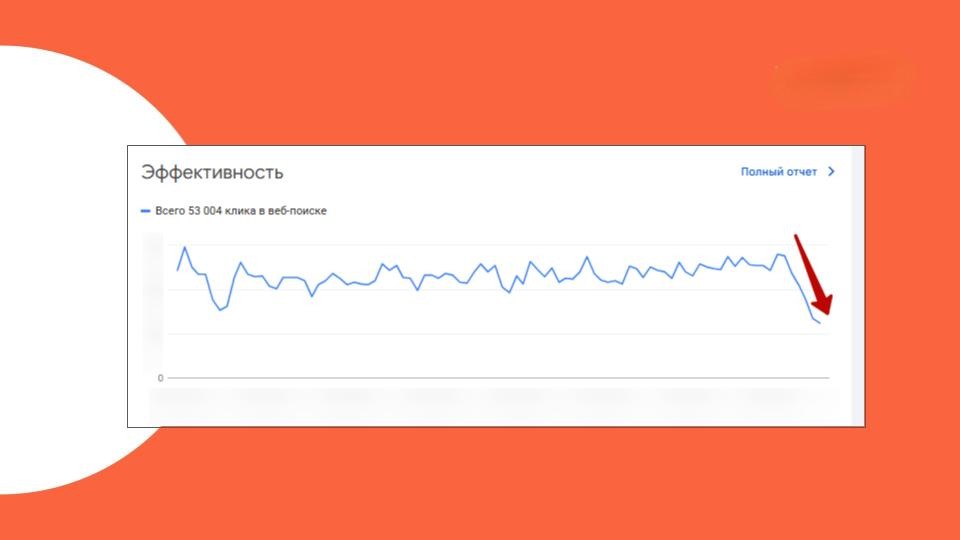
Упс, неувязка…
Звучит как сюжет триллера для SEO-специалиста? Добро пожаловать в нашу действительность. Мы в Webit столкнулись с сиим на одном из проектов. И сейчас поведаем, как находили черную кошку в черной комнате. Спойлер: причина оказалась поглубже, чем мы подразумевали – неувязка была в технических настройках на уровне сервера, которые обычно остаются вне поля зрения первичной SEO-диагностики.
1-ая догадка: robots.txt
На фоне понижения позиций и падения органического трафика было зафиксировано общее выпадение страничек из индекса. Мы начали с базисных проверок – удостоверились, что веб-сайт доступен, странички открываются корректно, а в панелях веб-мастеров нет очевидных ошибок либо предупреждений.
В процессе предстоящей проверки выяснилось, что Гугл не мог корректно обработать файл robots.txt. В итоге это приводило к дилеммам с индексацией страничек.
Гугл Search Console верно сигнализировал: доступ к robots.txt ограничен, файл не проходит переобход URL, странички не ворачиваются в индекс.
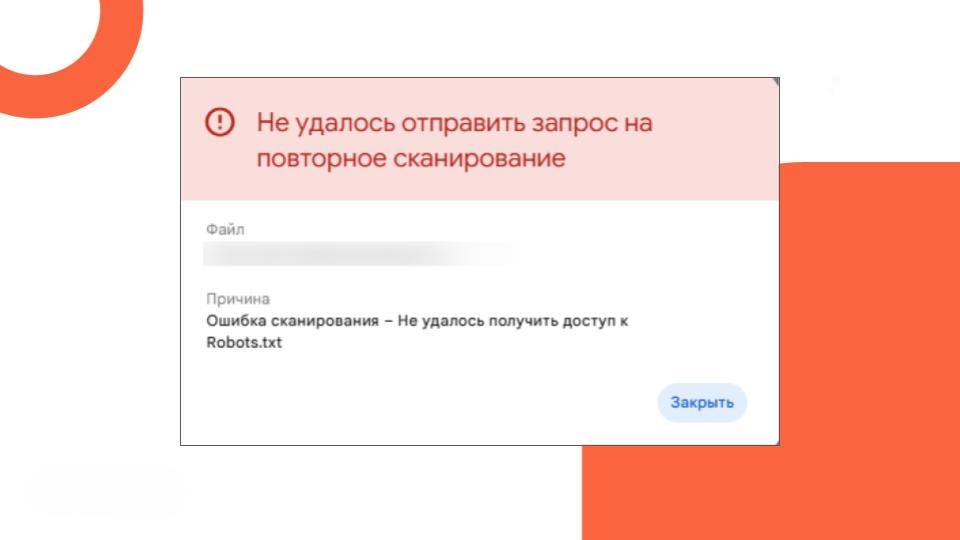
Гугл не может получить доступ к robots.txt
При анализе мы увидели, что незадолго до появления трудности в robots.txt были внесены конфигурации: корректировался блок User-Agent, возникла неправильная запись без указания значения *, также была добавлена директива Crawl-delay. На этом шаге мы разглядывали вариант, что причина быть может связана с синтаксисом либо логикой файла.
При всем этом сами по для себя эти конфигурации не должны были приводить к полной невозможности обработки robots.txt, ведь даже при наличии неправильных директив Гугл обычно способен обработать файл.
Тем не наименее, чтоб вполне исключить этот сценарий, мы вернули предшествующую заранее рабочую версию robots.txt и повторно выслали файл на проверку, но он как и раньше был недоступен для бота. Сделалось понятно, что дело не в содержимом. Robots.txt просто стал индикатором наиболее глубочайшей неудачи, поэтому что Googlebot пробовал до него добраться, но что-то на сервере не пускало.
Мы перебежали к технической диагностике.
Вскрытие: логи не лгут
Проанализировав логи сервера, мы узрели, что запросы Googlebot часто уходят в пустоту. Они не возвращают ошибку 404, не падают с 500-м, они просто… не обрабатываются. Как будто бот стучится в закрытую дверь, а ему никто не открывает.
Мы проверили доступность веб-сайта для Googlebot – снаружи все смотрелось нормально. Но в логах верно прослеживалась блокировка. Запросы от Googlebot попадали под фильтр и обрывались на уровне сервера.
И здесь мы копнули в сторону защиты. На проекте была настроена система Fail2ban – обычный инструмент для отражения атак. Она выслеживает подозрительную активность и автоматом перекрывает IP-адреса, которые очень нередко стучатся на сервер. Все правильно, так и обязано работать. Но неувязка была в одном узком аспекте: Fail2ban не делал исключений для поисковых ботов. Он лицезрел нередкие запросы с IP-адресов Googlebot, считал их атакой и… отрезал доступ.
Драматичность в том, что система делала свою работу идеально. Для людей веб-сайт был открыт, а для Гугл – закрыт. При всем этом никаких наружных признаков не наблюдалось: веб-сайт не падал, не тормозил, не демонстрировал ошибок.
В итоге:
-
Googlebot пробовал исследовать странички и получал отказ;
-
Гугл фиксировал, что доступ неосуществим, и выводил URL из индекса;
-
количество исключенных страничек росло;
-
падали позиции, видимость и поисковый трафик.
Решение: корректировка серверной защиты
Мы передали клиенту результаты диагностики и указали, что анализ серверных логов показал предпосылкой выявленных проблем систему защиты от роботов, настроенную на его стороне. Заказчик занес конфигурации в опции серверной защиты.
Опосля этого Googlebot получил доступ к файлу robots.txt, начал размеренно обходить веб-сайт, и странички одна за иной стали ворачиваться в индекс.
Вот что мы узрели в динамике.
-
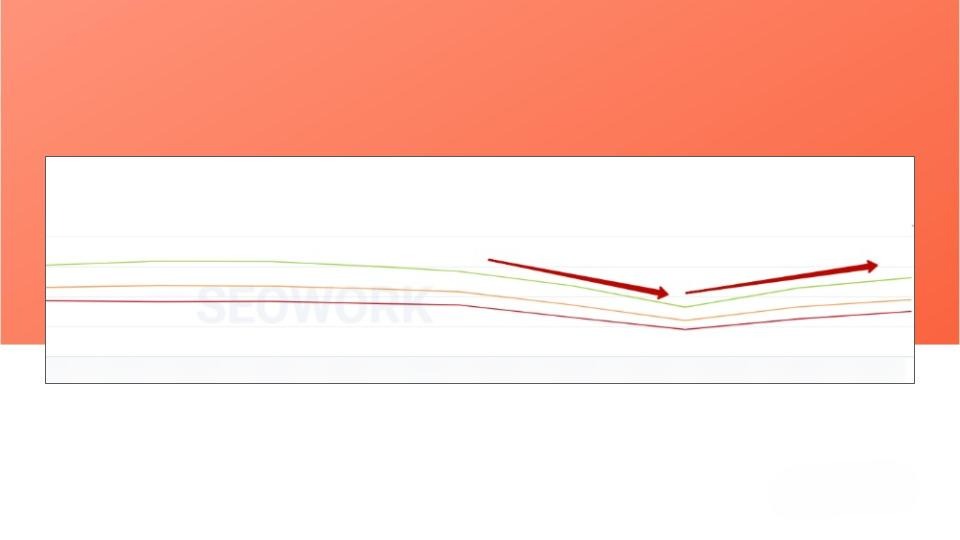
Доступность robots.txt восстановилась в течение суток.
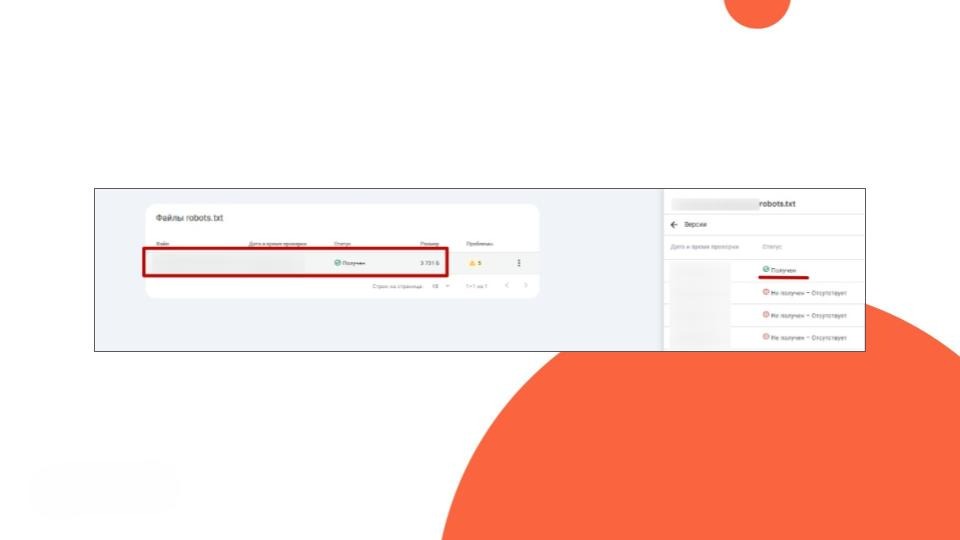
-
Странички начали ворачиваться в индекс.
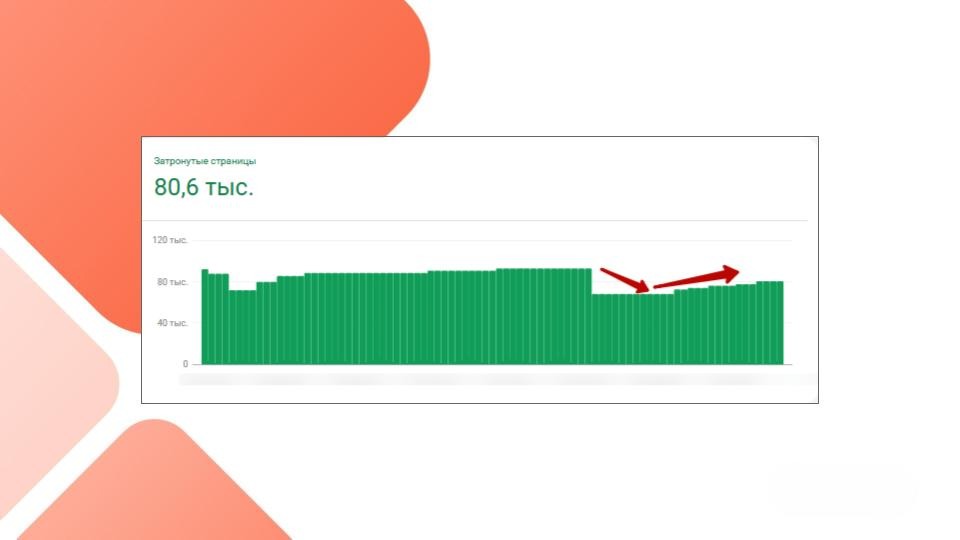
-
Позиции по главным запросам поползли ввысь.
-
Трафик равномерно возвратился к прежним значениям.
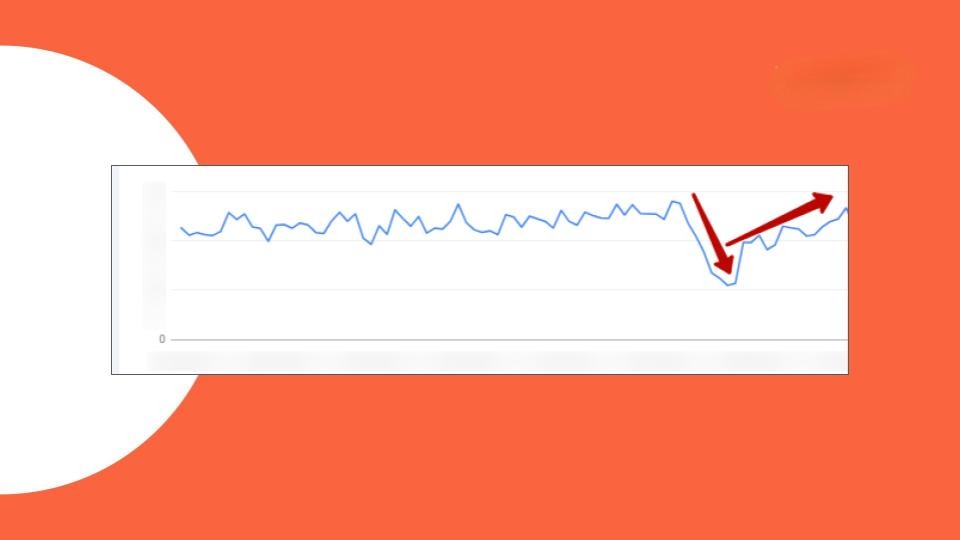
Принципиально: восстановление заняло время, поэтому что Гугл не возвращает странички в индекс по щелчку пальцев. Но тренд был устойчивым и положительным.
Инсайты для SEO-специалистов
Эта история – не про ошибку в настройках, а про «слепые» зоны, которые есть у почти всех компаний. Вот три основных инсайта, которые мы забрали с собой.
Веб-сайт быть может доступен для юзеров и невидим для Гугл. Странички открываются, формы работают, технических ошибок нет. Но при всем этом поисковый бот быть может заблокирован на уровне сервера. Снаружи эта неувязка никак не проявляется, вы узнаете о ней лишь постфактум, когда потеряете осязаемую долю трафика.
Search Console не постоянно орет о дилемме на главном экране. В этом проекте в GSC не было бардовых баннеров либо срочных советов. Неувязка скрывалась в разделе Опции → Сканирование → robots.txt и статистика сканирования. Там видна недоступность хоста и ошибки доступа к robots.txt. Если ограничиваться лишь главной страничкой GSC, то можно пропустить критичный сигнал.
Индексация – это не только лишь про контент и ссылки, да и про физический доступ. Даже корректный robots.txt, техно и контентная оптимизация не гарантируют индексацию, если Googlebot не может добраться до сервера. WAF, антибот-системы, Fail2ban, ограничения по IP и частоте запросов – все это может стать невидимым барьером.
Чек-лист: что инспектировать, если веб-сайт работает, а трафик падает
Сохраните этот перечень, он может сберечь для вас нервишки и бюджет.
Гугл Search Console
Проверить:
-
ошибки сканирования;
-
трудности с robots.txt;
-
исключенные странички;
-
возможность повторного запроса индексации.
В панели веб-мастера Гугл Search Console не постоянно сходу указывает на главном экране либо в блоке «советы» какие-то трудности, связанные с доступностью веб-сайта и robots.txt. Зайдите не только лишь во вкладку «Советы». Откройте Опции → Сканирование → robots.txt и статистика сканирования.
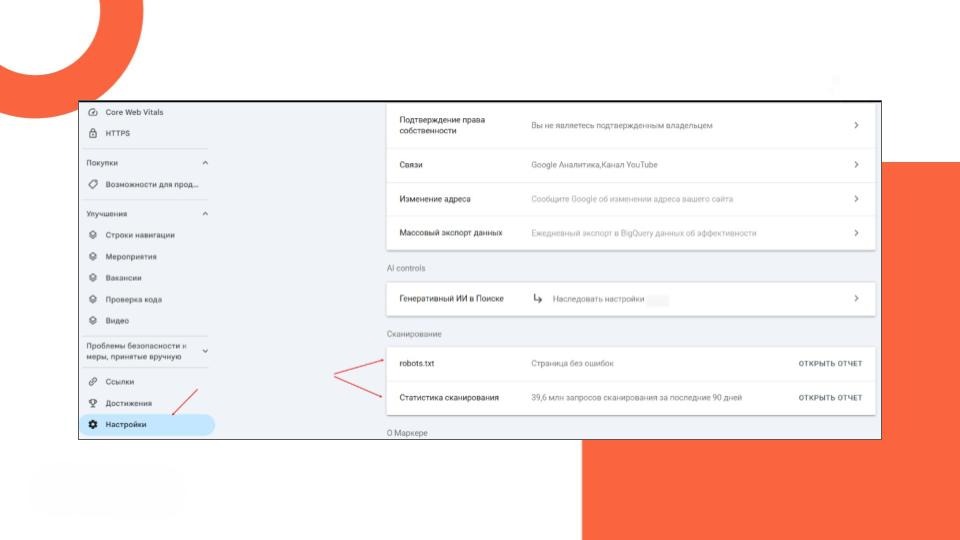
Там отыскиваете:
-
недоступность основного хоста либо поддоменов;
-
ошибки доступа к robots.txt;
-
любые аномалии в статистике сканирования.
Robots.txt
Проверьте не только лишь содержание, да и доступность файла. Если он недоступен для бота, то это практически постоянно это признак серверной блокировки, а не ошибки в синтаксисе.
Серверные логи
Проверьте, входит ли Googlebot на веб-сайт, какие коды ответа получает. Если в логах есть отказы без очевидной ошибки, то это повод копать в сторону блокировок.
Системы защиты (WAF, Fail2ban, антибот-фильтры)
Удостоверьтесь, что IP-адреса Googlebot не попали в темные списки. Проверьте опции ограничений по частоте запросов.
Эта история завершилась отлично. Блокировка снята, индексация восстановлена, трафик возвратился. Клиент сейчас понимает, что серверная инфраструктура тоже может стать зоной риска. А мы в очередной раз удостоверились: основное в SEO – инспектировать поглубже первичной SEO-диагностики.
Так что если ваш веб-сайт работает «как часы», а трафик падает – может быть, часы просто не лицезреют Googlebot. Проверьте логи.