

Воздействие дублей страничек на поисковую выдачу и методы устранения
Однообразное содержимое время от времени доступно по нескольким URL: с параметрами сортировки, различными регистрами букв либо отдельными адресами для мобильной версии. Поисковая машина обязана избрать основную страничку для показа. Неувязка возникает, когда она выбирает не тот вариант, который обладатель желал продвигать, или растрачивает ресурсы на ненадобные копии.
Какие повторения вправду мешают
Поначалу отличите полные дубли от близких по смыслу материалов. Продукт 1-го размера по двум ссылкам обычно относится к первой группе. Различные модели с схожими инструкциями могут заслуживать самостоятельных страничек. Механическое объединение всех пересекающихся текстов способно убить полезные точки входа.
Согласно справке Гугл, дублирование {само по себе} обычно не нарушает политику поискового мусора. Означает, утверждение о автоматическом штрафе за каждое совпадение ошибочно. Но препядствия обхода и выбора канонического адреса остаются.
|
Причина |
Пример |
Что проверить |
|
Характеристики сортировки |
`?sort=price` |
Различается ли основное содержание |
|
HTTP и HTTPS |
Два протокола |
Работает ли неизменный переход |
|
Метки кампаний |
`?utm_source=…` |
Не делают ли отдельную копию |
|
Группы и фильтры |
Цвет, размер, бренд |
Есть ли самостоятельный спрос |
В огромных каталогах количество композиций вырастает в особенности стремительно. Потому поначалу выясните, какие URL должны участвовать в поиске, а какие служат лишь для удобства выбора.
Как отыскать проблемные группы
В Гугл Search Console откройте отчет о индексировании страничек и изучите адреса с отметками о дублях. Потом проверьте несколько примеров через инструмент проверки URL: он покажет избранный канонический адресок. Данные дополните обходом веб-сайта краулером и анализом внутренних ссылок.
Соберите список шаблонов, создающих однообразное содержимое. Инспектируйте ответ сервера, тег `canonical`, карту веб-сайта и связи меж разделами.
Рабочая последовательность поможет не исправлять проявления заместо предпосылки. Сначала изучите массовые шаблоны.
-
Выгрузите группы схожих URL и разберите предпосылки их возникновения.
-
Изберите основную версию там, где содержимое вправду совпадает.
-
Согласуйте внутренние ссылки, редиректы и канонические указания.
-
Повторно проверьте выбор поисковой машины опосля переобхода.
Спецы WEBAGENT советуют начинать проверку с URL-шаблонов, которые генерируют больше всего дублей: характеристик фильтрации, сортировки и технических адресов. Таковой подход помогает резвее выявить общую причину препядствия и убрать ее сходу для целой группы страничек, а не исправлять любой адресок раздельно.
Не закрывайте весь каталог одним правилом в robots.txt. Таковой запрет может помешать боту узреть нужные сигналы на самих страничках.
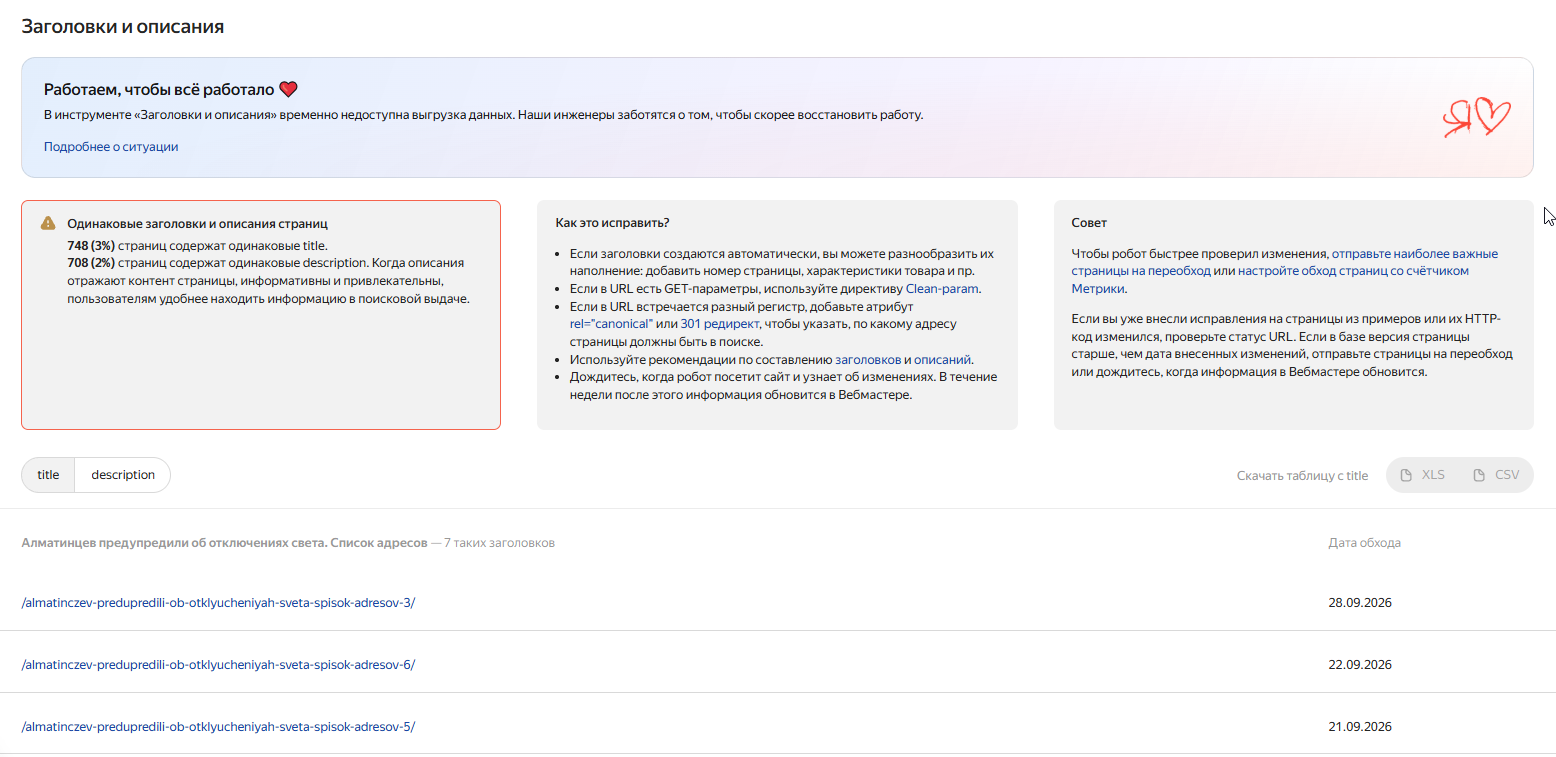
Какой способ избрать
Для совсем удаленного альтернативного адреса подступает неизменное перенаправление на действующую версию, если содержание соответствует запросу. Когда параметр нужен гостю, а главный материал совпадает, можно указать желательный URL через `rel=»canonical»`. В справке Гугл говорится, что это мощный сигнал, но не бесспорный приказ.
Если страничка обязана существовать для юзера, но не появляться в выдаче, разглядите `noindex`. При всем этом поисковому боту требуется доступ к документу, чтоб узреть директиву. Сочетать ограничения без осознания порядка обработки небезопасно.
Раздельно разберитесь с пагинацией и вариациями продукта. Страничка последующей части каталога содержит иной набор позиций, потому указание первой в качестве канонической может оказаться ошибкой.
Отдельный источник копий – распечатка, мобильные шаблоны и плохая настройка многоязычности. Если у разделов различаются язык либо реальное предназначение, их недозволено автоматом считать излишними. В таком случае проверьте международную разметку, пользовательские маршруты и содержательную самостоятельность всякого варианта.
Собирайте контрольные примеры опосля больших обновлений платформы. Разраб может случаем поменять порядок характеристик либо не делать выводить верный канонический адресок на части карточек. Проверка нескольких шаблонов выявит такую ошибку ранее, чем покажутся бессчетные второстепенные URL.
Как не получить делему опять
Опосля исправления шаблона проверьте, куда ведут меню, фильтры, карточки и хлебные крошки. Ссылки на второстепенные версии продолжают направлять обход в ненужную сторону. Карта веб-сайта обязана содержать созданные для индексации адреса.
Комфортно закрепить несколько постоянных проверок. Они в особенности полезны опосля обновления CMS либо конфигурации маршрутизации.
-
возникновение новейших характеристик без пользовательской задачки;
-
конфликтующие канонические указания;
-
цепочки перенаправлений;
-
однообразные заглавия у различных нужных материалов.
Не оценивайте исправление лишь по падению числа проиндексированных URL. Время от времени это ожидаемый итог объединения копий. Сопоставляйте его с доступностью принципиальных разделов, органическими переходами и правильностью избранных адресов.
Читайте также:
- SEO для цветочного магазина и доставки букетов
- Как продвигать веб-сайт окон ПВХ и услуг остекления
- Продвижение веб-сайтов с динамическим контентом: курсы валют и погода