
Страничка есть в sitemap, но не находится в поиске: как поделить обнаружение, обход и индексацию
Строчка в sitemap нередко воспринимается как заявка на непременное возникновение странички в поиске. Отсюда возникает знакомый вопросец: «URL есть в карте веб-сайта – почему его нет в выдаче?» Неувязка в том, что карта веб-сайта решает лишь часть задачки. Она помогает поисковой машине выяснить о желательном URL, но не гарантирует незамедлительный обход, включение в индекс либо позиции по запросам.
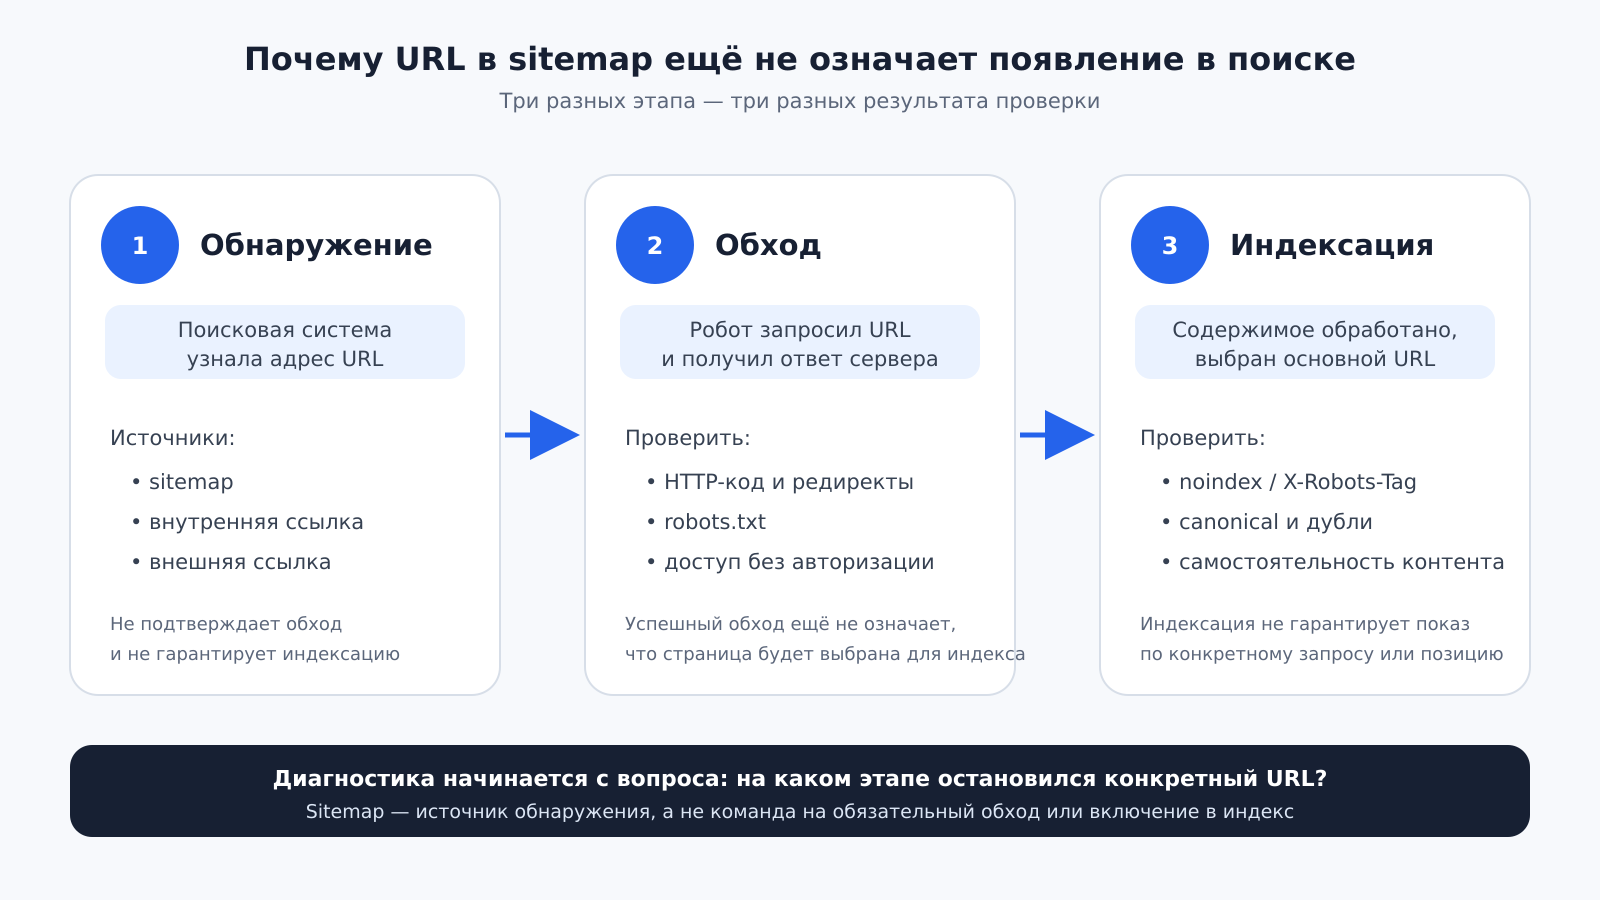
Чтоб находить причину без догадок, полезно поделить процесс на три шага: обнаружение, обход и индексацию. На любом шаге есть собственный проверяемый итог и собственный набор вероятных препятствий.
Почему URL в sitemap еще не значит возникновение в поиске
Шаг 1. Обнаружение: поисковая машина выяснила о URL
Страничка считается обнаруженной, когда поисковая машина получила ее адресок. Источником быть может sitemap, внутренняя ссылка, наружная ссылка либо ранее узнаваемый вариант URL. На этом шаге идет речь лишь о адресе, а не о содержимом странички.
Наличие URL в корректной карте веб-сайта – нужный сигнал, в особенности для новейшего, большого либо почти не связанного внутренними ссылками веб-сайта. Но sitemap не подменяет навигацию. Если принципиальная страничка находится лишь в XML-файле и на нее недозволено перейти по обыкновенной ссылке с остальных страничек, это повод проверить архитектуру веб-сайта.
Для 1-го URL поначалу ответьте на четыре вопросца:
-
в карте указан полный адресок с правильным протоколом и доменом;
-
это конкретно тот вариант URL, который обладатель считает главным;
-
sitemap доступен поисковому боту и обработан без ошибок;
-
на страничку ведет хотя бы одна рядовая внутренняя ссылка.
Учебный пример: в sitemap записан адресок https://example.com/catalog/item, а меню и карточки категорий ссылаются на https://www.example.com/catalog/item/. Для юзера странички могут смотреться идиентично, но для диагностики это различные URL. До проверки индексации необходимо найти, какой адресок является главным, и согласовать sitemap, внутренние ссылки, редиректы и canonical.
Шаг 2. Обход: бот сумел получить страничку
Опосля обнаружения поисковая машина решает, когда запросить URL. Сам факт присутствия в sitemap не значит, что бот уже открыл страничку. Меж обнаружением и обходом может пройти время; повторная отправка постоянной карты веб-сайта пару раз в денек не превращает подсказку в команду.
На шаге обхода принципиально проверить не наружный вид странички в браузере обладателя, а ответ, который получает поисковый бот. Малый технический набор смотрится так:
-
страничка доступна без авторизации, cookie-сценария и ручного доказательства;
-
сервер возвращает код 200, а не цепочку редиректов, ошибку либо «мягенькую» страничку 404;
-
robots.txt не воспрещает обход подходящего пути;
-
сервер не отвечает неустойчиво и не ограничивает бота из-за перегрузки;
-
основное содержимое доступно при загрузке странички, а не возникает лишь опосля деяния, которое бот не должен делать.
Robots.txt регулирует обход, но его не следует употреблять как всепригодный метод убрать страничку из поиска. Если бот не может открыть URL, он не увидит размещенную на страничке директиву noindex. Потому запрет обхода и запрет индексации – различные механизмы с различными последствиями.
Для диагностики полезно сравнить данные инструмента проверки URL в Search Console с журнальчиками сервера. 1-ый указывает, что поисковая машина понимает о определенном адресе и какой итог получила при проверке. Серверный лог отвечает на иной вопросец: запрашивал ли бот этот URL и какой ответ дал веб-сайт. Эти источники дополняют друг дружку.
Шаг 3. Индексация: содержимое обработано и избран главный вариант
Даже удачно открытая страничка может не попасть в индекс. Опосля обхода поисковая машина анализирует содержимое, директивы индексации и дела меж схожими URL. Потом она может избрать иной адресок в качестве канонического.
На этом шаге проверьте:
-
нет ли meta robots со значением noindex в итоговом HTML;
-
нет ли заголовка X-Robots-Tag с запретом индексации;
-
показывает ли rel=canonical на ожидаемый URL;
-
не ведет ли страничка неизменным либо временным редиректом на иной адресок;
-
не является ли она полным либо практически полным дублем уже известной странички;
-
есть ли на ней самостоятельное содержимое, соответственное заявленной задачке.
В sitemap имеет смысл включать желательные канонические URL, которые обладатель вправду желает созидать в поиске. Если карта веб-сайта именует главным один адресок, canonical – 2-ой, а внутренние ссылки ведут на 3-ий, поисковой машине приходится без помощи других разбирать противоречивые сигналы.
Принципиально различать две ситуации: «страничка не проиндексирована» и «страничка проиндексирована, но не показывается по избранному запросу». 2-ая ситуация уже не решается повторной отправкой sitemap. Индексирование {само по себе} не гарантирует показ по определенной формулировке и не подтверждает позиции.
Метод проверки 1-го URL
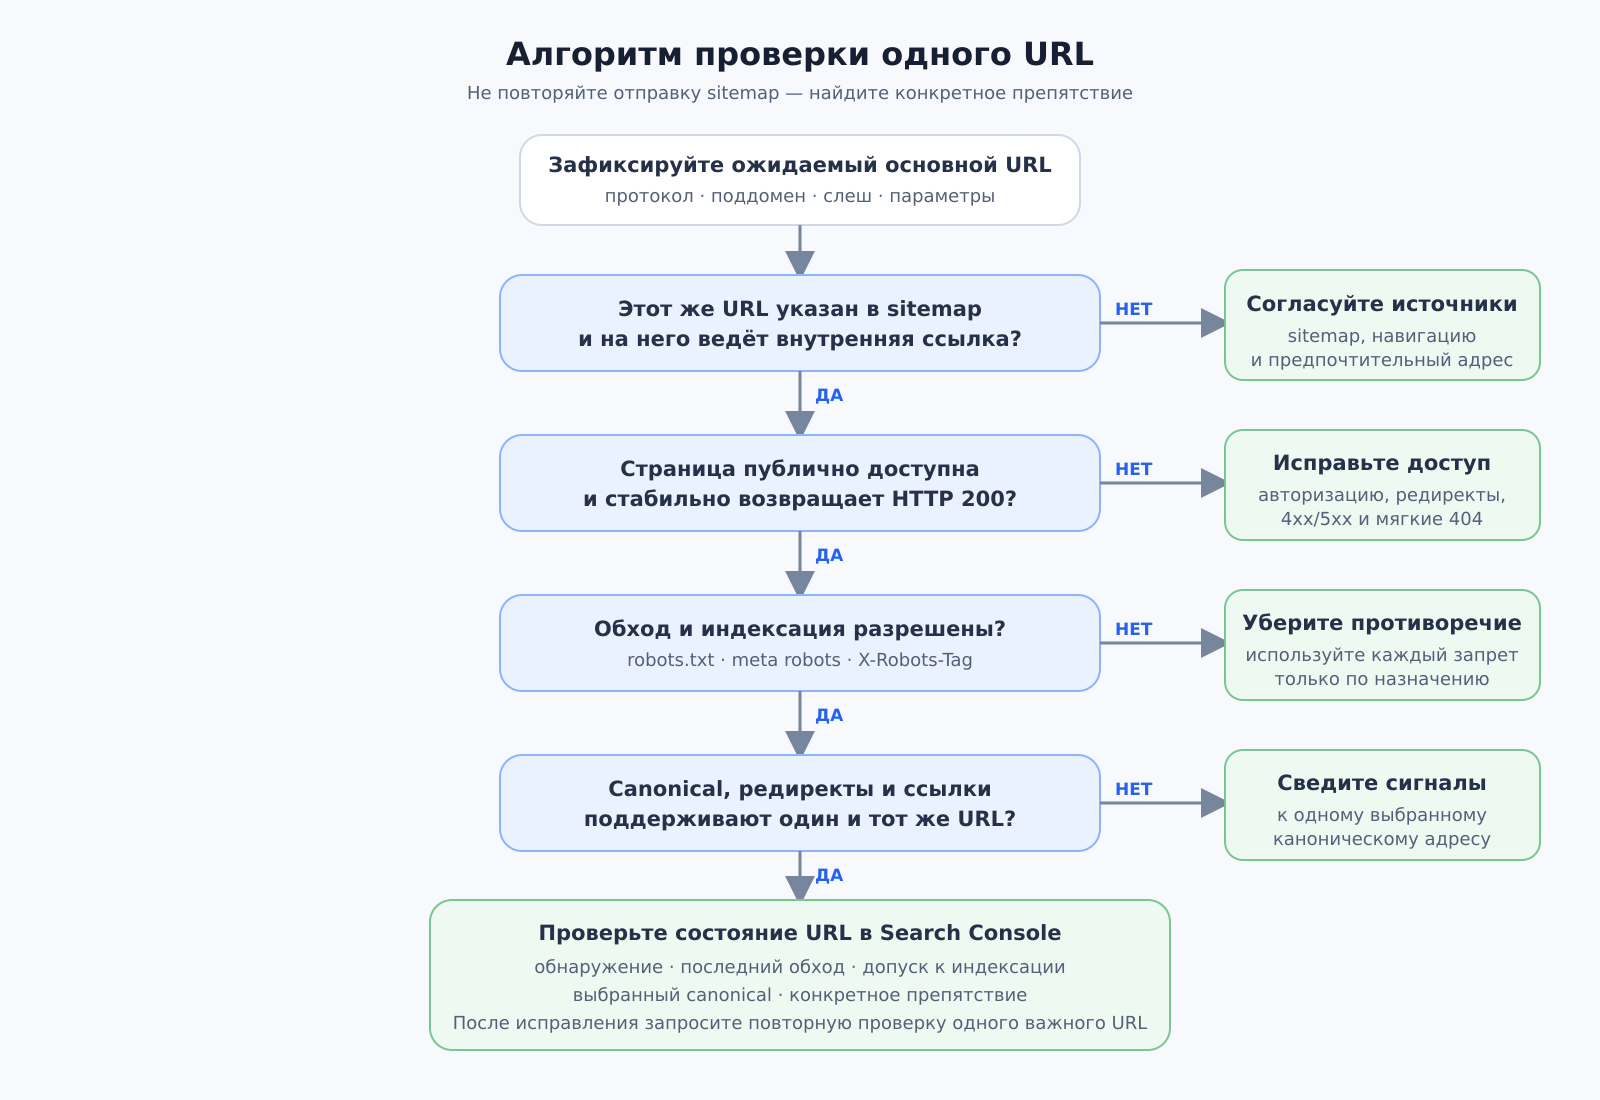
Практический метод для 1-го URL
-
Зафиксируйте ожидаемый адресок. Запишите четкий URL, который должен быть главным: протокол, поддомен, регистр, оканчивающий слеш и характеристики.
-
Проверьте sitemap. Удостоверьтесь, что в нем указан этот адресок, файл раскрывается и не содержит устаревших вариантов странички. Дата lastmod обязана отражать существенное обновление странички, а не автоматическое каждодневное изменение файла.
-
Проверьте путь по веб-сайту. Найдите обыденную HTML-ссылку на страничку из пригодного раздела. Принципиальный материал не должен оставаться изолированным лишь поэтому, что его адресок внесен в карту веб-сайта.
-
Проверьте ответ сервера. Ожидаемый итог – доступная общественная страничка с кодом 200. Раздельно зафиксируйте редиректы, ошибки 4xx и 5xx, нестабильные ответы и мягенькие 404.
-
Сверьте ограничения. Проверьте robots.txt, meta robots и X-Robots-Tag. Не делайте вывод лишь по начальному шаблону: важен итоговый ответ, который получает бот.
-
Сверьте канонические сигналы. Соотнесите canonical, редиректы, внутренние ссылки и адресок в sitemap. Они должны поддерживать один избранный вариант.
-
Поглядите состояние URL в Search Console. Разделите ответы «известен ли адресок», «был ли он обойден», «допущен ли к индексации» и «какой canonical избрала система».
-
Исправьте конкретное препятствие. Опосля технического исправления запросите повторную проверку 1-го принципиального URL. Для группы страничек обновите карту веб-сайта и внутренние ссылки. Не отправляйте один и этот же запрос неоднократно в ожидании моментального результата.
Как не потеряться в массовой дилемме
Если идет речь не о одной страничке, а о сотках URL, проверка по одному адресу стремительно преобразуется в случайную подборку. Разделите странички на однородные группы: карточки продуктов, группы, статьи, служебные фильтры, архивы. Для каждой группы возьмите несколько примеров с схожим шаблоном и сравните sitemap, внутренние ссылки, ответ сервера, директивы и canonical.
Комфортная рабочая таблица может содержать семь столбцов: ожидаемый URL, источник обнаружения, код ответа, разрешение обхода, директива индексации, заявленный canonical и избранный поисковой машиной canonical. Крайний столбец – конкретное действие, а не общий статус «проверить SEO».
Учебный пример: у 10 карточек продукта в sitemap указан главный URL, но внутренние ссылки ведут на варианты с параметром сортировки, а canonical возвращает адресок группы. Это не 10 независящих загадок, а возможная ошибка общего шаблона. Исправление шаблона следует инспектировать на маленькой группе, а потом распространять на раздел.
Что sitemap подтверждает – и чего же не подтверждает
Корректная карта веб-сайта подтверждает, что обладатель сказал поисковой машине о наборе желательных URL. Она помогает обнаружению и дает доп сигнал о канонических адресах. Но она не подтверждает, что любой URL уже обойден, проиндексирован либо будет показан юзеру.
Потому вопросец «почему странички нет в поиске?» лучше поменять 3-мя поочередными вопросцами:
-
Поисковая машина понимает четкий URL.
-
Бот сумел получить страничку без технических препятствий.
-
Опосля обработки страничка допущена в индекс конкретно под ожидаемым каноническим адресом.
Таковой порядок не обещает секундную индексацию, зато превращает спор с картой веб-сайта в воспроизводимую проверку. У всякого шага возникает наблюдаемый итог, а у каждой трудности – конкретное последующее действие.