
Schema.org, llms.txt, robots.txt и AI-краулеры: что реально влияет на доступность веб-сайта для AI-поиска
В материалах про GEO на данный момент просто повстречать один и этот же набор советов: добавить llms.txt, открыть GPTBot, ввести Schema.org и ожидать, когда нейросети начнут лучше созидать веб-сайт.
Неувязка в том, что эти инструменты решают различные задачки. А часть фаворитных советов пробует вылечивать GEO там, где у веб-сайта рядовая неувязка с техническим SEO.
Если подходящий бот получает 403, страничка закрыта в robots.txt либо главный контент не доезжает до краулера, дискуссировать специальную разметку для AI пока рано.
Потому поначалу разберемся, какие механизмы вправду влияют на техно доступность веб-сайта для AI-поиска, а какие пока остаются тестом.
Поначалу проверить, может ли бот совершенно получить страничку
Для Гугл тут нет отдельного набора технических требований специально под AI Overviews и AI Mode. Страничка обязана соответствовать обыденным требованиям Гугл Search: быть доступной для обхода, проиндексированной и иметь возможность показываться в поиске со сниппетом. Гугл раздельно показывает, что никаких доп технических требований для AI-функций нет.
Потому 1-ая проверка не много различается от обыденного технического SEO-аудита:
-
страничка отвечает 200 OK;
-
URL доступен без неотклонимой авторизации;
-
подходящий раздел не закрыт в robots.txt;
-
на страничке случаем не установлен noindex;
-
canonical показывает на верный URL;
-
главный контент доступен краулеру;
-
JavaScript не мешает получить критически принципиальный текст;
-
CDN либо WAF – инфраструктура доставки и защиты веб-сайта – не заблокируют подходящего бота.
Скучнее, чем дискуссировать новейшие файлы для LLM. Зато конкретно тут нередко находится причина, почему система не может нормально получить страничку.
Логика технической проверки выходит таковой:
- robots.txt – можно ли обходить URL;
- HTTP и рендеринг – получает ли бот содержимое;
- noindex и canonical – как поисковику работать со страничкой;
- sitemap.xml – какие URL необходимо найти;
- Schema.org – что находится на страничке;
- llms.txt – доп экспериментальный слой.
Такое разделение было заложено и в начальной структуре материала.
«Бот OpenAI» уже очень общее понятие
Одна из нередких ошибок – открыть GPTBot и решить, что сиим веб-сайт подготовлен к ChatGPT Search.
У больших AI-платформ различные краулеры делают различные задачки.
|
Система |
User-agent |
Для что употребляется |
|
OpenAI |
OAI-SearchBot |
поиск и отображение веб-сайтов в ChatGPT Search |
|
OpenAI |
GPTBot |
возможный сбор контента для развития моделей |
|
Anthropic |
Claude-SearchBot |
поиск и улучшение результатов поиска Claude |
|
Anthropic |
Claude-User |
получение странички по запросу юзера |
|
Anthropic |
ClaudeBot |
сбор контента для развития моделей |
|
Perplexity |
PerplexityBot |
поиск и показ веб-сайтов в результатах Perplexity |
|
Perplexity |
Perplexity-User |
получение странички по запросу юзера |
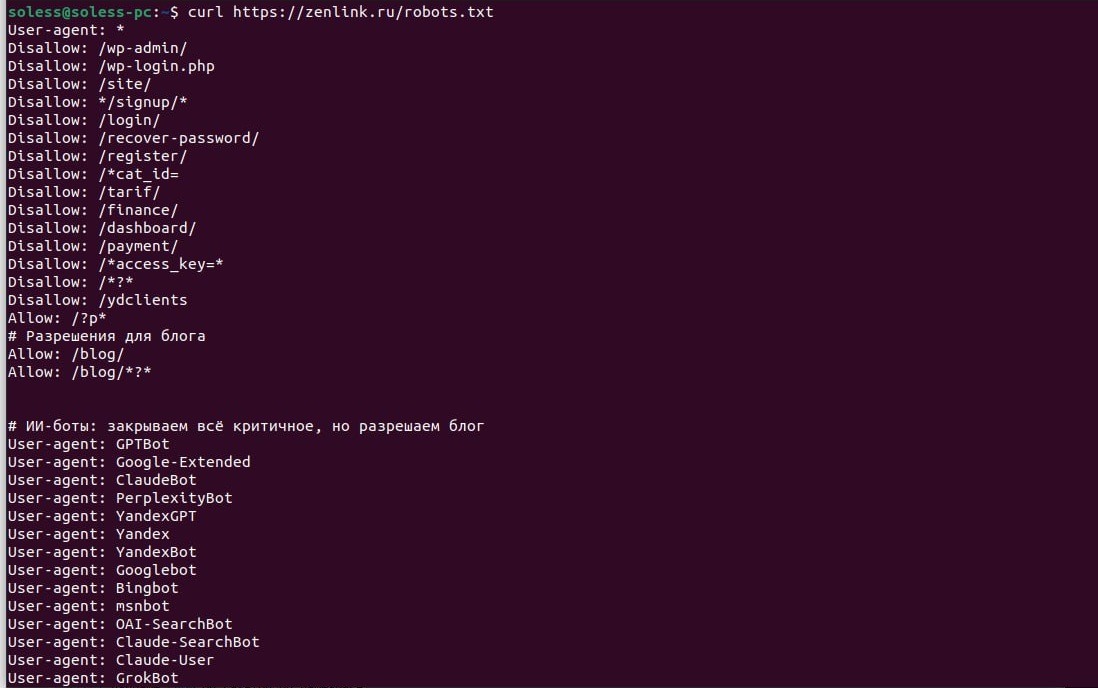
Фрагмент robots.txt Zenlink: в одном файле могут быть прописаны поисковые, AI-search и остальные краулеры с отдельными правилами доступа
На практике 1-го перечня user-agent недостаточно. К примеру, при проверке robots.txt мы раздельно смотрим, какие правила используются к поисковым AI-краулерам, ботам для обучения моделей и обыденным поисковым ботам. Само наличие OAI-SearchBot либо Claude-SearchBot в файле еще ничего не гласит, если не поглядеть, что конкретно им разрешено либо запрещено.
OpenAI советует не перекрыть OAI-SearchBot, если веб-сайт должен всеполноценно появляться в ChatGPT Search. При всем этом GPTBot отвечает за иной сценарий и быть может запрещен независимо от поискового бота.
У Anthropic разделение еще нагляднее: ClaudeBot связан с возможным внедрением контента для обучения, Claude-SearchBot работает с поиском, а Claude-User обращается к веб-сайту по пользовательскому запросу. Все три бота Anthropic поддерживают правила robots.txt.
Perplexity тоже делит автоматический поисковый обход и пользовательские запросы. PerplexityBot предназначен для поиска и ссылок на веб-сайты в результатах Perplexity. А Perplexity-User срабатывает, когда юзер сам инициирует получение странички. Тут есть принципиальный аспект: Perplexity прямо пишет, что таковой пользовательский fetcher обычно игнорирует правила robots.txt.
Потому вопросец «разрешены ли AI-боты?» очень общий. Поточнее спрашивать: какому user-agent нужен доступ и для какой задачки.
И очередной момент: Allow: / значит лишь то, что правила robots.txt не воспрещают этому боту обход URL. Это не обещание индексации, цитирования либо возникновения странички в AI-ответе.
robots.txt и noindex работают на различных уровнях
Эти два механизма до сего времени соединяют даже в технических ТЗ.
Если кратко:
-
robots.txt задает правила обхода URL для краулеров, которые их соблюдают;
-
noindex докладывает поисковой машине, что полученную страничку не надо включать в индекс.
К примеру, на страничке стоит:
< meta name="robots" content="noindex" >
Но URL сразу закрыт в robots.txt.
В таковой ситуации бот может совершенно не получить HTML странички и, соответственно, не узреть noindex. Гугл прямо показывает, что robots meta directives работают лишь тогда, когда краулер может получить страничку.
OpenAI обрисовывает аналогичную ситуацию для ChatGPT Search: чтоб OAI-SearchBot сумел прочесть метатег noindex, доступ к страничке поначалу должен быть разрешен.
У Гугл есть и отдельные директивы для управления тем, сколько содержимого может употребляться в AI Overviews и AI Mode:
-
nosnippet воспрещает демонстрировать текстовый сниппет и применять содержимое странички как прямой источник для этих AI-функций;
-
data-nosnippet дозволяет закрывать от сниппета отдельные части странички;
-
max-snippet ограничивает размер текста, который Гугл может применять;
-
noindex исключает страничку из поиска.
Выходит, часть управления AI-поиском уже издавна живет снутри обыденных SEO-директив. Отдельный geo-meta-super-tag для этого не пригодился.
Schema.org полезна, но не как «фактор GEO»
Schema.org – это словарь сущностей и параметров. А структурированные данные на его базе дают поисковым системам машиночитаемое описание содержимого странички: где находится организация, создатель, статья, продукт, хлебные крошки и остальные сути. Гугл употребляет для этого, а именно, JSON-LD, Microdata и RDFa.
Обычный пример для статьи:
{
"@context": "https://schema.org",
"@type": "Article",
"headline": "Заглавие статьи",
"author": {
"@type": "Person",
"name": "Имя создателя"
},
"datePublished": "2026-08-20"
}
Применять такую разметку нормально. Созодать из нее отдельный фактор AI-ранжирования – уже нет.
Гугл прямо пишет, что для AI Overviews и AI Mode не требуется особая Schema.org-разметка. Структурированные данные должны соответствовать тому, что юзер реально лицезреет на страничке, но сами по для себя не гарантируют возникновение в генеративной выдаче.
В 2026 году платформа для SEO-аналитики Ahrefs попробовала проверить это на данных. Исследователи отследили 1 885 страничек, которые добавили JSON-LD, и сравнили их приблизительно с 4 000 контрольных страничек.
В ChatGPT и Гугл AI Mode статистически важного роста цитирований опосля прибавления Schema.org не нашли. Для AI Overviews исследование показало маленькое понижение относительно контрольной группы, но сами создатели раздельно предупреждают: это не обосновывает, что Schema.org усугубляет AI-видимость.
У исследования есть ограничения:
-
анализировались странички, которые уже интенсивно цитировались AI;
-
речь шла конкретно о JSON-LD;
-
различные типы Schema рассматривались совместно;
-
эффект отслеживался на ограниченном временном окне.
Потому вывод тут достаточно размеренный: структурированные данные остаются обычным инвентарем технического SEO и помогают очевидно обрисовывать сути, но доказанного роста AI-цитирований лишь за счет Schema.org пока нет.
llms.txt: мысль не плохая, доказательств пока меньше
Мысль файла понятна: положить в корень веб-сайта Markdown-документ, который кратко обрисовывает проект и содержит ссылки на принципиальные материалы.
К примеру:
# Example
> Короткое описание проекта
## Documentation
— [Документация](https://example.com/docs)
— [API](https://example.com/api)
По плану выходит маленькая карта веб-сайта в комфортном для LLM и AI-агентов формате.
Но llms.txt пока остается предложенной спецификацией. Это не аналог robots.txt, не механизм контроля доступа и не утвержденный веб-стандарт. Сам файл ничего не разрешает и ничего не воспрещает.
Для Гугл ситуация сформулирована достаточно прямо: особые machine-readable AI-файлы вроде llms.txt не необходимы, чтоб веб-сайт мог появляться в AI Overviews либо AI Mode.
А в июне 2026 года Ahrefs опубликовал исследование уже по настоящим запросам к серверам.
В подборку вошли 137 210 доменов. Около 28% из их имели валидный llms.txt, но 97% этих файлов за май 2026 года не получили совершенно ни 1-го запроса.
Даже посреди оставшихся 3% картина оказалась не в особенности впечатляющей для AI Search:
-
96% запросов к файлам приходили от роботов;
-
лишь 19,5% всех воззваний к читаемым llms.txt были от идентифицированных AI-инструментов;
-
AI retrieval bots вроде OAI-SearchBot, PerplexityBot и поискового бота Claude дали только маленькую долю запросов;
-
исследователи не нашли попыток AI-ботов без помощи других находить llms.txt на веб-сайтах, где такового файла не было.
Это не значит, что формат бесполезен навечно. Его могут применять AI-агенты, инструменты для разрабов либо будущие системы.
Но на сентябрь 2026 года оснований включать llms.txt в неотклонимый набор технических работ по GEO не много.
Если файл создается автоматом и практически ничего не стоит в поддержке, экспериментировать можно. Если выбор стоит меж ним и исправлением заморочек с обходом, индексацией либо HTML странички, поначалу логичнее чинить базу.
Sitemap.xml все еще кислый, но нужный
На фоне новейших GEO-терминов sitemap.xml смотрится практически архаично. Но свою задачку он делает.
Sitemap помогает поисковой машине обнаруживать URL, которые веб-сайт предоставляет для обхода. При всем этом наличие странички в sitemap не гарантирует ни crawling, ни indexing.
В sitemap разумно держать канонические URL, которые вправду предполагается регистрировать.
С lastmod работает этот же принцип: дата полезна, если отражает реальное изменение странички. Автоматом обновлять ее любой денек на всех URL смысла не много.
Сам sitemap.xml при всем этом решает совершенно другую задачку, чем robots.txt и Schema.org:
- robots.txt – правила обхода;
- sitemap.xml – обнаружение URL;
- canonical / noindex – работа с определенной страничкой;
- Schema.org – описание содержимого.
Соединять это в один пункт «оптимизация под AI» не весьма полезно.
С JavaScript лучше не спорить на теоретическом уровне
Еще одна всераспространенная формулировка: «AI-краулеры не могут JavaScript».
Для практической работы она очень общая.
Гугл JavaScript рендерить умеет. У остальных краулеров способности могут различаться, а некие AI-системы получают документы через поисковые индексы либо собственные механизмы поиска и получения контента. Гугл раздельно обрисовывает crawling, rendering и indexing как различные этапы обработки JavaScript-страниц.
Обычный пример:
< body >
< div id="content" >< /div >
< script >
loadArticle();
< /script >
< /body >
В браузере юзер может отлично созидать текст. Но это еще не значит, что подходящий краулер получил то же содержимое.
Потому на определенном веб-сайте полезнее проверить:
-
HTTP-ответ.
-
Начальный HTML.
-
Итог рендеринга.
-
Серверные логи.
-
Опции CDN и WAF.
-
Запросы от подходящего user-agent.
Крайний пункт в особенности важен. User-agent сам по для себя можно подделать, потому для критических проверок стоит сопоставлять его с размещенными IP-диапазонами либо иными механизмами верификации, если платформа их предоставляет.
Время от времени расследование «почему AI не лицезреет веб-сайт» завершается еще ранее Schema.org и llms.txt: сервер просто возвращает подходящему краулеру 403 Forbidden.
В котором порядке инспектировать веб-сайт перед GEO-экспериментами
Если собрать все совместно, технический аудит удобнее вести от базисных вещей к экспериментальным:
-
нужные странички отвечают 200 OK;
-
контент доступен без неотклонимой авторизации;
-
robots.txt не перекрывает подходящего поискового краулера;
-
проверен определенный user-agent, а не абстрактный «AI-бот»;
-
CDN и WAF не режут его запросы;
-
на страничке нет случайного noindex;
-
canonical показывает на подходящую версию URL;
-
sitemap содержит нужные канонические странички;
-
главный текст находится в содержимом, которое реально получает бот;
-
проверен JavaScript-рендеринг;
-
серверные логи подтверждают фактический обход;
-
структурированные данные валидны и соответствуют видимому контенту;
-
llms.txt, если он нужен проекту, идет уже опосля базисных проверок.
Выходит мало иронически: поиск приметно поменялся, возникли AI Overviews, AI Mode, ChatGPT Search, отдельные AI-краулеры и новейший термин GEO.
А значимая часть технических заморочек с «видимостью для AI» как и раньше решается неплохим техническим SEO.